
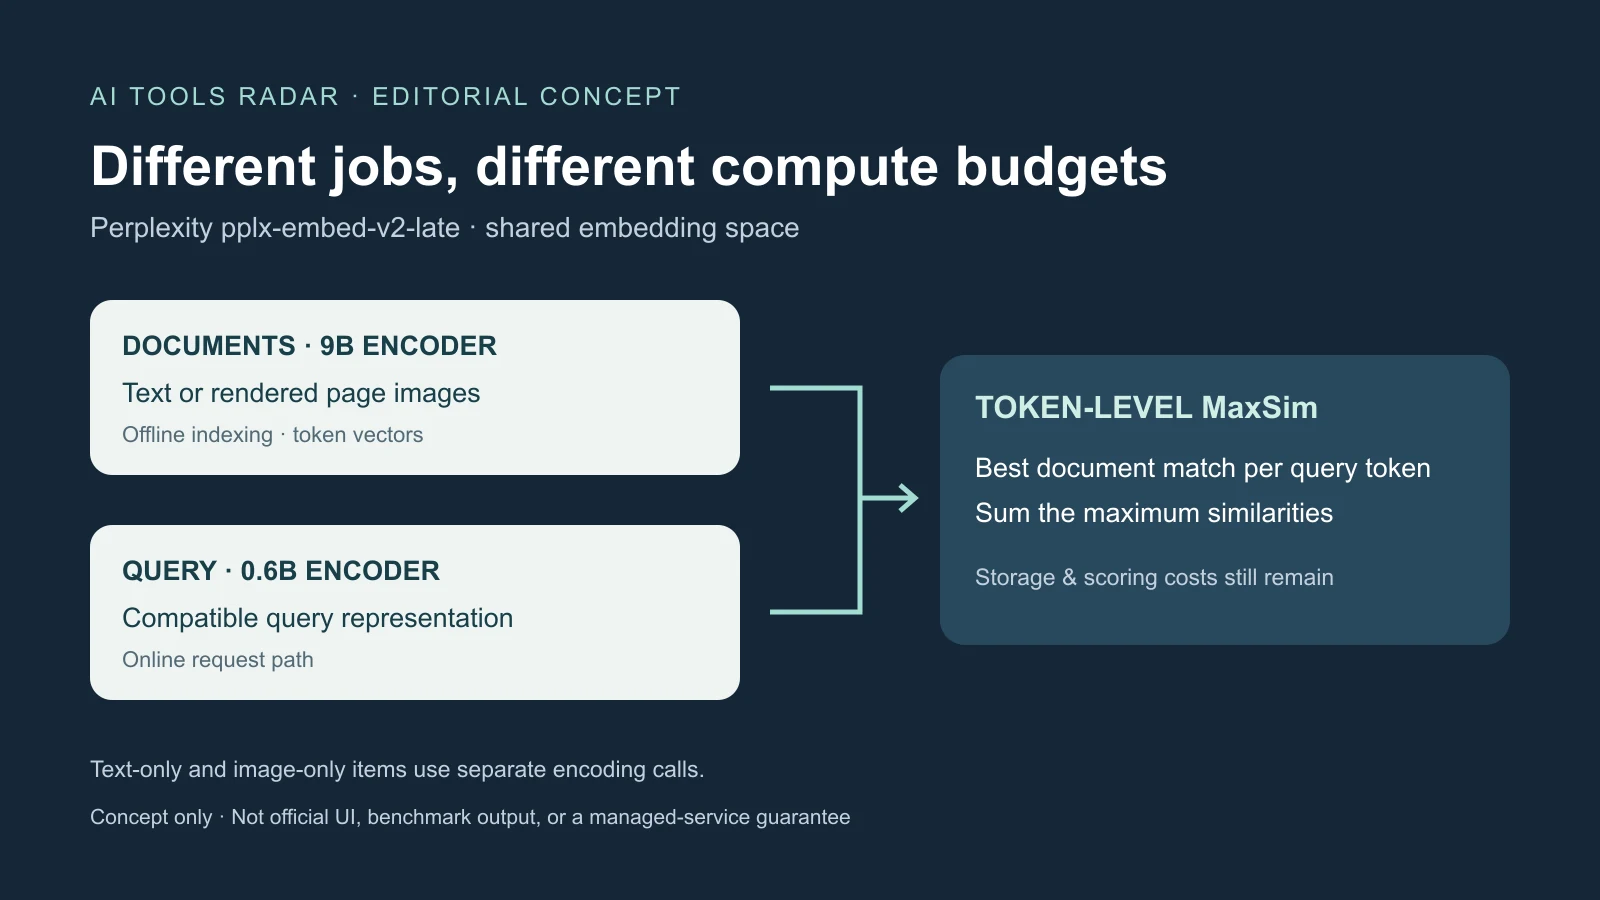
Los dos checkpoints pplx-embed-v2-late de Perplexity, bajo MIT, proponen otro reparto en recuperación multimodal. Un codificador 9B puede construir un índice documental más rico mientras un 0,6B compatible atiende consultas en directo. Lo permite el espacio compartido, no solo menos parámetros.
Ambos codifican texto, imágenes y páginas renderizadas. Los documentos pueden procesarse por lotes fuera de línea y amortizarse en muchas búsquedas; las consultas se repiten en la ruta sensible a latencia. Repartir cómputo es la hipótesis práctica, no promesa de bajo coste total.
Vectores por token conservan detalles comprimidos en uno solo
La recuperación densa suele asignar un vector a consulta y documento o fragmento, facilitando vecinos cercanos. Dividir ayuda con longitud pero puede separar tabla y etiqueta o cláusula y condición. Los cross-encoders comparan conjuntamente cada pareja, repitiendo el modelo por candidato y normalmente reordenando listas breves.
Late interaction precodifica documentos conservando tokens. Cada uno tiene 128 dimensiones; MaxSim busca la mayor similitud documental por token de consulta y suma esos máximos. Norma, plazo y excepción pueden coincidir con distintas evidencias de una página, en vez de mezclarse.
La familia Qwen3.5 usa atención bidireccional y destilación de un profesor ColBERT 18B interno. La empresa ajustó todo el pequeño; en 9B ajustó las ocho capas Transformer finales y aplicó LoRA a las restantes y al codificador visual.
El pequeño tiene unos 594 millones de parámetros totales y 340 millones activos declarados: unos 240 millones para texto y 340 para imagen. La torre textual Qwen3.5-0.8B se redujo de 24 a 12 capas; la tabla de tokens aporta otros 254 millones. “0,6B” no significa idéntico cálculo activo en todas las entradas.
El espacio común permite consultas 0,6B sobre documentos 9B sin reconstruir el índice solo por cambiar el codificador de consultas. También se propone codificación local pequeña con índice cloud 9B. Son opciones, no privacidad automática ni garantía de servicio gestionado.
Buscar sin OCR todavía requiere ingestión
La aplicación renderiza páginas PDF como imágenes antes del codificador visual; no entrega directamente un archivo sin preparar. La representación puede preservar posición de tablas, relaciones de diagramas y diseño, evitando algunos errores de escaneos o tipografías.
No suministra automáticamente pasajes para citas, resaltado, búsqueda léxica, cumplimiento o contexto del modelo lingüístico. Texto nativo u OCR puede acompañar: localizar visualmente la página y recuperar después evidencia exacta. Renderizar, normalizar, tratar fallos, metadatos, revisiones y borrados sigue siendo trabajo de la aplicación.
Perplexity declara 186 millones de pares de 594 datasets y 46 idiomas. Proporciones originales: 88,3% texto–texto, 8,3% texto–imagen y 3,4% texto–documento visual; pesos finales: 56,5%, 30,9% y 12,6%. Buscar fotos y evidencia en informes densos son problemas diferentes: la mezcla importa.
Elementos solo textuales y solo visuales requieren llamadas separadas; no se admite texto e imagen mezclados en un mismo elemento. Multimodal no elimina esa restricción de ingestión.
Las mejoras asimétricas tienen comparadores concretos
En 72 tareas de dominio, la empresa informa de 1,6 puntos porcentuales medios más para consulta 0,6B/documento 9B que para 0,6B en ambos lados, sin cambiar consultas. ViDoRe v3 imágenes alcanza 63,5% nDCG@10 frente a 62,3%, diferencia de 1,2 puntos.
El 9B simétrico sigue mejor con media de dominio 81,3%. La asimetría recuperaría aproximadamente la mitad de la brecha textual sin mayor codificación de consultas. Justifica probar el gran indexador, no afirmar que el pequeño solo iguala todos los resultados 9B.
ViDoRe v3 público da 65,2% de imagen para 9B y 62,3% para 0,6B; Markdown, 64,7% y 61,2%. La empresa sitúa el pequeño a 1,2 puntos de Nemotron ColEmbed V2 8B y compara Qwen3-VL-Embedding, EVIE y TopK Embed.
Las 128 dimensiones por token contrastan con 2.048 de EVIE-4.5B y 4.096 de EVIE y Nemotron mayores. Reducen cada vector, no necesariamente todo el índice. Tokens retenidos, precisión, compresión, metadatos, estructura y candidatos también determinan almacenamiento; faltan cálculos completos de corpus representativos.
Los benchmarks de respuestas miden más que embeddings
En BrowseComp+, Perplexity declara 64,0% de acierto 9B, 4,9 puntos por delante del siguiente ColBERT y 8,7 del siguiente denso. Son 830 consultas difíciles y unos 100.000 documentos web seleccionados con evidencias verificadas por personas. El corpus fijo favorece reproducción, pero difiere de la web viva cambiante.
El resultado combina recuperación con GPT-OSS-120B a esfuerzo alto y otro modelo juzgando contra referencias. Mide agente y retriever, no embedding aislado. El pequeño superaría a todos fuera de familia, pero no todos los valores estaban en texto consultable; el informe completo se prometió para más adelante ese año.
MADQA con Gemini 3.5 Flash da 92,4% para 9B y 90,1% para 0,6B. El artículo original describe 2.250 preguntas humanas sobre 800 documentos; esta evaluación usa 500 preguntas en más de 18.000 páginas, exigiendo pruebas del corpus y no conocimiento general.
9B supera Mixedbread estándar con el mismo agente por 3,5 puntos. Mixedbread Agentic Search llega al 93,4%, dentro del intervalo de confianza según Perplexity, pero incluye subagente que planifica varias búsquedas por llamada externa. Un servicio entero y un componente no son comparación equivalente.
Los autores MADQA observan sistemas cercanos a humanos acertando preguntas distintas y compensando mala estrategia con búsquedas repetidas. Un retriever mejor no garantiza planificación o síntesis. Acierto, recuperación de páginas de evidencia, calidad, latencia y llamadas deben medirse separados.
El PPLX-Q2I privado usa registros productivos: 10.000 consultas contra 100.000 imágenes. Ambos superarían Qwen3-VL-Embedding-8B por más de nueve puntos y 9B quedaría unos dos detrás de Gemini Embedding 2. Externos no pueden reproducirlo todavía; son afirmaciones empresariales.
Consultas pequeñas no eliminan puntuación y memoria
La búsqueda densa almacena un vector por documento o fragmento; late interaction muchos tokens, y MaxSim hace más trabajo que un producto interno por candidato. Servir eficientemente requiere índices, poda o etapas apropiadas; documentos largos pesan aun con 128 dimensiones.
Hay que medir aparte codificación de consulta, candidatos, MaxSim y reordenación o generación posterior. Un codificador pequeño todavía puede desencadenar comparaciones caras con millones de vectores. Corpus cambiantes exigen GPU continuas, recodificación y borrados.
La búsqueda densa conserva valor a escala enorme, la léxica protege nombres e identificadores exactos y cross-encoders reordenan candidatos limitados. Una base técnica híbrida reserva imágenes para páginas dependientes del diseño y texto para búsqueda exacta, citas y evidencias. Contenido no autorizado debe filtrarse antes del agente; vectores locales y cloud compatibles no son control de acceso.
La viabilidad en dispositivos depende de memoria, aceleración, cuantización y batería. El pequeño publicado usa tensores F32; menor precisión exige comprobar rankings. La ficha requiere Sentence Transformers 6.0+ y Transformers 5.4+, advirtiendo de distinta posición de marcadores de consulta y documento en PyLate.
Módulos nativos Sentence Transformers evitan Python personalizado pero no construyen índice o servicio. Ningún proveedor de inferencia ofrecía el pequeño en la ficha citada. El plan gradual de API para embeddings late interaction, densos y contextuales no es endpoint activo ni fundamento para inferir precios de servicios antiguos de un vector.
Pesos abiertos permiten comprobar la hipótesis, no resolverla
MIT permite uso y modificación amplios, pero siguen revisiones de dependencias, datos de entrenamiento y documentos sensibles. Pesos e instrucciones no publican corpus completo ni profesor interno 18B. La exclusión declarada de datasets relacionados con benchmarks requiere el informe prometido para examinar contaminación, ajustes e incertidumbre.
Pruebas independientes deben reproducir simetría y asimetría en materiales legales, financieros, técnicos y escaneados, con duplicados, revisiones, permisos, diseños parecidos, escritura manual y negativos difíciles. Igual presupuesto completo evita presentar mejor OCR, búsquedas adicionales o reordenación como ganancia del embedding.
Deciden reproducción independiente, datos completos de hardware, latencia, compresión y memoria y soporte real al recorrido mixto. Ingestión, índice, recuperación de evidencia, respuestas y fallos deben medirse juntos. La hipótesis es clara: documentos offline y consultas online no necesitan igual cómputo. Su ventaja sobre búsqueda simple después de todos los costes sigue siendo empírica.
Fuentes y lecturas relacionadas
Ficha del modelo 0,6B · Explicación técnica · Lectura: conocimiento técnico consultable · Diseño BrowseComp+ · Artículo MADQA · Anuncio