
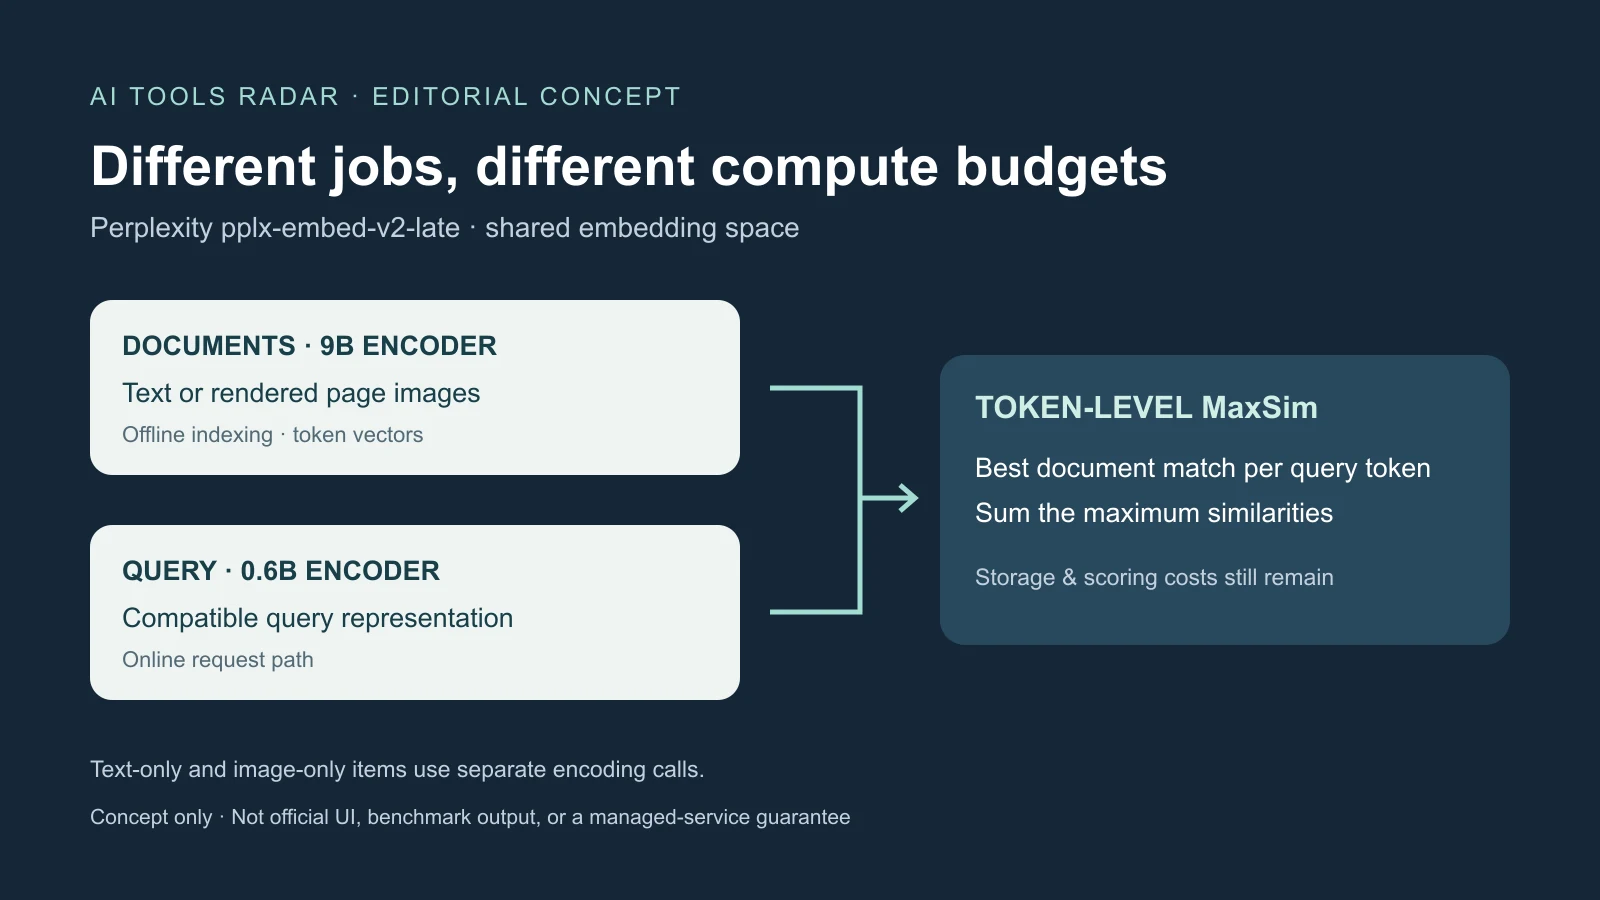
Os dois checkpoints pplx-embed-v2-late da Perplexity, com licença MIT, propõem outra divisão de trabalho na recuperação multimodal. Um codificador 9B pode construir um índice documental mais rico enquanto o 0,6B compatível atende consultas ao vivo. É o espaço compartilhado, não apenas menos parâmetros, que permite a assimetria.
Ambos codificam texto, imagens e páginas renderizadas. Documentos podem ser processados offline em lotes e amortizados em muitas buscas; consultas repetem-se no caminho sensível à latência. Distribuir recursos entre essas tarefas é a hipótese prática, não promessa de custo total baixo.
Vetores por token preservam detalhes comprimidos em um só vetor
Recuperação densa normalmente dá um vetor à consulta e outro ao documento ou trecho, viabilizando busca eficiente de vizinhos. Dividir o texto ajuda com extensão, mas pode separar tabela e legenda ou cláusula e ressalva. Cross-encoders comparam o par conjuntamente, porém repetem o modelo para cada candidato e costumam reordenar listas curtas.
Late interaction pré-codifica documentos mantendo representações de tokens. Cada token tem 128 dimensões. MaxSim encontra para cada token da consulta a maior similaridade documental e soma esses máximos. Lei, prazo e exceção podem encontrar evidências distintas na mesma página, em vez de serem misturados.
A família Qwen3.5 usa atenção bidirecional e destilação de um professor ColBERT 18B interno. A Perplexity ajustou integralmente o menor; no 9B, ajustou as oito camadas finais do Transformer e aplicou LoRA nas restantes e no codificador visual.
O pequeno tem cerca de 594 milhões de parâmetros totais e 340 milhões ativos declarados: aproximadamente 240 milhões no texto e 340 milhões nas imagens. A torre Qwen3.5-0.8B foi reduzida de 24 para 12 camadas; a tabela de embeddings soma outros 254 milhões. “0,6B” não implica computação ativa igual para toda entrada.
O espaço comum deixa consultas 0,6B pesquisar documentos 9B sem reconstruir o índice só por trocar o codificador de consulta. A empresa também propõe codificação pequena local junto de índice 9B na nuvem. São opções, não garantias automáticas de privacidade ou serviço gerenciado.
Recuperação sem OCR ainda exige ingestão
A aplicação renderiza páginas PDF em imagens antes do codificador visual; não entrega um PDF despreparado diretamente. A representação visual pode preservar posições de tabelas, relações de diagramas e layout, evitando alguns erros de scans e fontes.
Ela não fornece automaticamente trechos para citações, destaque, busca lexical, conformidade ou contexto ao modelo de linguagem. Texto nativo ou OCR pode acompanhar: encontrar a página visualmente e extrair a evidência exata depois. Renderização, normalização, falhas, metadados, revisões e exclusão continuam trabalho da aplicação.
A Perplexity relata 186 milhões de pares em 594 datasets e 46 idiomas. As proporções originais foram 88,3% texto–texto, 8,3% texto–imagem e 3,4% texto–documento visual; pesos finais de amostragem foram 56,5%, 30,9% e 12,6%. Buscar fotografias e achar prova em relatório denso são tarefas diferentes, tornando a mistura relevante.
Itens somente texto e somente imagem exigem chamadas de codificação separadas; misturar texto e imagem no mesmo item não é suportado. A palavra multimodal não elimina esse limite de ingestão.
Ganhos assimétricos têm comparações específicas
Em 72 tarefas de domínio, a empresa declara ganho médio de 1,6 ponto percentual para consulta 0,6B/documento 9B contra 0,6B dos dois lados, sem mudar a consulta. No ViDoRe v3 de imagens foram 63,5% nDCG@10 contra 62,3%, diferença de 1,2 ponto.
O 9B simétrico continuou melhor, com média de domínio 81,3%. A empresa diz recuperar aproximadamente metade da diferença textual sem consulta maior. Isso justifica testar indexador grande, não dizer que o pequeno sozinho iguala todos os resultados 9B.
No ViDoRe v3 público de imagens, os valores foram 65,2% para 9B e 62,3% para 0,6B; em Markdown, 64,7% e 61,2%. O menor ficou, segundo a empresa, a 1,2 ponto do Nemotron ColEmbed V2 8B, em comparação também com Qwen3-VL-Embedding, EVIE e TopK Embed.
As 128 dimensões por token contrastam com 2.048 do EVIE-4.5B e 4.096 de modelos maiores EVIE e Nemotron. Isso reduz cada vetor, não necessariamente o índice todo. Tokens retidos, precisão, compressão, metadados, estrutura e geração de candidatos também determinam armazenamento; faltam cálculos completos de corpora representativos.
Benchmarks de respostas medem mais que embeddings
No BrowseComp+, a Perplexity relata 64,0% de acurácia do 9B, vantagem de 4,9 pontos sobre o próximo ColBERT e 8,7 sobre o próximo modelo denso. São 830 consultas difíceis e aproximadamente 100.000 documentos web curados com provas verificadas por humanos. Um corpus fixo melhora reprodução, mas difere da web viva em mudança.
O resultado combina recuperação com GPT-OSS-120B em alto esforço, usando outro modelo para julgar respostas contra referências. É resultado de agente e retriever, não métrica isolada de embeddings. A empresa diz que 0,6B superou todos fora da família, mas nem todas as pontuações estavam em texto pesquisável; relatório completo foi prometido para depois naquele ano.
No MADQA com Gemini 3.5 Flash, os valores são 92,4% para 9B e 90,1% para 0,6B. O artigo original descreve 2.250 questões humanas em 800 documentos; esta avaliação usa subconjunto de 500 questões sobre mais de 18.000 páginas, exigindo evidência do acervo, não conhecimento geral.
O 9B superou recuperação Mixedbread padrão com o mesmo agente em 3,5 pontos. Mixedbread Agentic Search atingiu 93,4%, dentro do intervalo de confiança segundo a Perplexity, mas inclui subagente que planeja várias buscas por chamada externa. Serviço completo e componente não são comparação equivalente.
Os autores do MADQA observam sistemas próximos dos humanos acertando perguntas diferentes e compensando estratégia fraca com buscas repetidas. Melhor recuperação não garante planejamento ou síntese. Acurácia, recall de páginas de evidência, qualidade de busca, latência e chamadas de ferramentas exigem medidas separadas.
O privado PPLX-Q2I usa logs de produção: 10.000 consultas contra 100.000 imagens. A empresa afirma que ambos superam Qwen3-VL-Embedding-8B em mais de nove pontos, e 9B fica cerca de dois atrás de Gemini Embedding 2. Não é reproduzível externamente e permanece atribuído à empresa.
Consulta pequena não remove pontuação e armazenamento
A busca densa armazena um vetor por documento ou trecho; late interaction mantém muitos tokens, e MaxSim faz mais trabalho que um produto interno por candidato. Servir com eficiência requer índices adequados, poda ou etapas; documentos longos pesam mesmo em 128 dimensões.
É preciso separar tempo de codificação da consulta, geração de candidatos, MaxSim e reordenação ou geração posterior. Codificador pequeno ainda pode pedir comparações caras em milhões de vetores. Corpora que mudam frequentemente exigem capacidade GPU contínua, recodificação e exclusão.
Busca densa continua útil em escala enorme, lexical protege nomes e identificadores exatos, cross-encoders reordenam candidatos limitados. Uma base técnica híbrida pode reservar índices visuais a páginas dependentes de layout, mantendo texto para busca precisa, citações e evidências. Conteúdo não autorizado deve ser filtrado antes do agente; vetores locais e cloud compatíveis não são controle de acesso.
Viabilidade no dispositivo depende de memória, aceleração, quantização e bateria. O checkpoint pequeno usa tensores F32; conversões menores exigem checagem do ranking. A ficha exige Sentence Transformers 6.0+ e Transformers 5.4+, alertando para posição diferente dos marcadores de consulta/documento no PyLate.
Módulos nativos Sentence Transformers evitam Python personalizado, mas não entregam índice ou serviço. Na ficha citada, nenhum provedor de inferência atendia o pequeno. O plano gradual de API para embeddings late interaction, densos e contextuais não é endpoint em produção nem base para inferir preços de serviços antigos de vetor único.
Pesos abertos tornam a hipótese testável, não resolvida
MIT permite amplo uso e modificação, mas exige revisão de dependências, dados de treinamento e documentos sensíveis. Pesos e instruções não revelam todo o corpus nem professor 18B interno. A alegação de excluir dados ligados aos benchmarks requer o relatório prometido para avaliar contaminação, configurações e incerteza.
Testes independentes devem reproduzir simetria e assimetria em documentos jurídicos, financeiros, técnicos e escaneados, incluindo duplicatas, revisões, permissões, layouts semelhantes, manuscritos e negativos difíceis. Orçamentos completos iguais evitam que melhor OCR, mais buscas ou reordenação pareçam ganhos de embeddings.
Decidem reprodução independente, dados completos de hardware, latência, compressão e armazenamento e suporte real ao caminho misto. Ingestão, índice, recall, respostas e falhas devem ser medidos juntos. A hipótese é clara: documentos offline e consultas online não precisam da mesma verba computacional. A vantagem sobre busca simples após todos os custos operacionais continua empírica.
Fontes e leituras relacionadas
Ficha do modelo 0,6B · Explicação técnica · Leitura: conhecimento técnico pesquisável · Desenho BrowseComp+ · Artigo MADQA · Anúncio do lançamento