
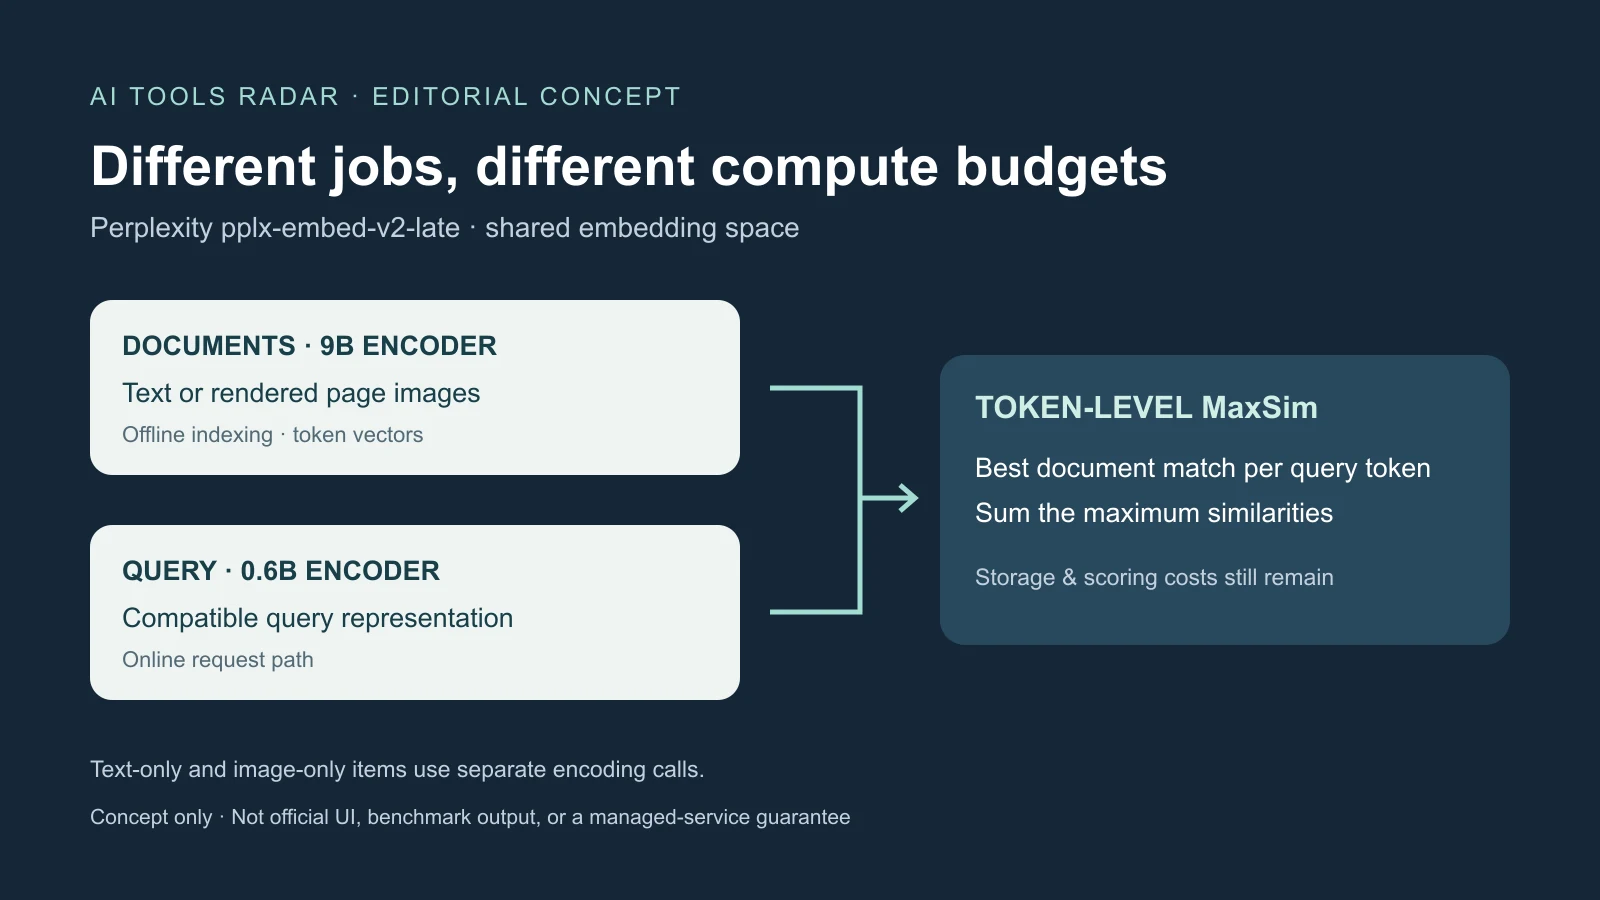
I due checkpoint pplx-embed-v2-late di Perplexity con licenza MIT propongono una diversa divisione del recupero multimodale. Un encoder 9B può creare un indice documentale più ricco, mentre uno 0,6B compatibile gestisce query in tempo reale. È lo spazio condiviso, non solo il minor numero di parametri, a consentire l’asimmetria.
Entrambi codificano testo, immagini e pagine renderizzate. I documenti si elaborano offline in lotti, ammortizzando il costo su molte ricerche; le query si ripetono nel percorso sensibile alla latenza. Allocare diversamente il calcolo è l’ipotesi pratica, non promessa di basso costo totale.
I vettori per token conservano dettagli compressi dal vettore unico
Il recupero denso assegna di norma un vettore alla query e uno al documento o frammento per ricerca efficiente dei vicini. Il chunking aiuta con la lunghezza ma può separare tabella e didascalia o clausola e limitazione. I cross-encoder confrontano insieme ogni coppia, ripetendo il modello per candidato, solitamente per riordinare liste brevi.
Late interaction precodifica documenti conservando i token. Ciascuno ha 128 dimensioni; MaxSim cerca il token documentale più simile a ogni token della query e somma i massimi. Norma, scadenza ed eccezione possono trovare prove diverse nella stessa pagina invece di fondersi in un’unica rappresentazione.
La famiglia Qwen3.5 usa attenzione bidirezionale e distillazione da un insegnante ColBERT 18B interno. Il piccolo è stato interamente affinato; per 9B sono stati affinati gli ultimi otto strati Transformer, usando LoRA nei restanti e nell’encoder visivo.
Il piccolo ha circa 594 milioni di parametri totali e dichiarati 340 milioni attivi: circa 240 milioni per testo e 340 milioni per immagini. La torre testuale Qwen3.5-0.8B è stata ridotta da 24 a 12 strati; la tabella dei token pesa altri 254 milioni. “0,6B” non indica identico calcolo attivo per ogni input.
Query 0,6B possono cercare documenti 9B grazie allo spazio comune, senza ricostruire l’indice solo per cambiare encoder delle query. Perplexity propone anche codifica piccola sul dispositivo e indice 9B cloud. Sono opzioni, non privacy automatica o garanzie di servizio gestito.
Ricerca senza OCR richiede comunque ingestione
L’applicazione renderizza pagine PDF in immagini prima dell’encoder visivo; non passa direttamente un file impreparato. Le rappresentazioni possono preservare posizione delle tabelle, relazioni dei diagrammi e impaginazione, evitando alcuni errori di scansioni o caratteri.
Non forniscono automaticamente testo per citazioni, evidenziazione, ricerca lessicale, conformità o contesto ai modelli linguistici. Testo nativo e OCR possono affiancare il visivo: trovare la pagina promettente, poi recuperare la prova precisa. Rendering, normalizzazione, errori, metadati, revisioni e cancellazioni restano lavoro applicativo.
L’azienda riporta 186 milioni di coppie da 594 dataset e 46 lingue. Le quote originali sono 88,3% testo–testo, 8,3% testo–immagine e 3,4% testo–documento visivo; i pesi finali diventano 56,5%, 30,9% e 12,6%. Cercare fotografie e prove in pagine dense sono compiti diversi: la miscela conta.
Elementi solo testuali e solo visivi richiedono chiamate separate; un singolo elemento misto testo e immagine non è supportato. L’etichetta multimodale non elimina tale limite.
I miglioramenti asimmetrici hanno confronti specifici
Su 72 compiti di dominio Perplexity dichiara un guadagno medio di 1,6 punti percentuali per query 0,6B/documenti 9B rispetto a 0,6B da entrambi i lati, senza cambiare l’encoder di query. ViDoRe v3 immagini dà 63,5% nDCG@10 contro 62,3%, differenza di 1,2 punti.
Il 9B simmetrico resta migliore con media di dominio 81,3%. Secondo l’azienda l’asimmetria recupera circa metà del divario testuale senza query più grandi. Giustifica provare il grande indicizzatore, non sostenere che il piccolo da solo uguagli ogni risultato 9B.
I punteggi pubblici ViDoRe v3 immagini sono 65,2% per 9B e 62,3% per 0,6B; Markdown rispettivamente 64,7% e 61,2%. L’azienda colloca il piccolo entro 1,2 punti da Nemotron ColEmbed V2 8B e confronta anche Qwen3-VL-Embedding, EVIE e TopK Embed.
Le 128 dimensioni per token si confrontano con 2.048 di EVIE-4.5B e 4.096 dei maggiori EVIE e Nemotron. Si riduce il singolo vettore, non necessariamente l’intero indice. Token conservati, precisione, compressione, metadati, struttura e candidati determinano memoria; manca un calcolo completo su corpora rappresentativi.
I benchmark di risposta misurano più degli embedding
Per BrowseComp+ l’azienda riporta 64,0% di accuratezza 9B, 4,9 punti sopra il prossimo ColBERT e 8,7 sopra il prossimo denso. Sono 830 query difficili e circa 100.000 documenti web curati con prove verificate da persone. Il corpus fisso favorisce riproduzione, ma differisce dal web in mutamento.
Il risultato associa recupero a GPT-OSS-120B ad alto sforzo, con altro modello che giudica contro risposte di riferimento. Misura agente e retriever, non l’embedding isolato. Il piccolo avrebbe battuto tutti fuori famiglia, ma non tutti i valori erano in testo ricercabile; il rapporto completo era previsto più avanti nell’anno.
MADQA con Gemini 3.5 Flash dà 92,4% per 9B e 90,1% per 0,6B. Lo studio originale descrive 2.250 domande umane su 800 documenti; l’evaluation usa un sottoinsieme di 500 domande e oltre 18.000 pagine, richiedendo prove dal corpus e non conoscenza generale.
9B supera Mixedbread standard con lo stesso agente di 3,5 punti. Mixedbread Agentic Search arriva a 93,4%, nell’intervallo di confidenza secondo Perplexity, ma include un subagente che pianifica più ricerche per chiamata esterna. Servizio completo e componente non sono comparabili allo stesso livello.
Gli autori MADQA osservano sistemi vicini all’accuratezza umana risolvere domande diverse e compensare strategie deboli con ricerche ripetute. Un retriever migliore non garantisce pianificazione o sintesi. Accuratezza, richiamo delle pagine di prova, qualità di recupero, latenza e chiamate vanno separati.
Il privato PPLX-Q2I usa log produttivi: 10.000 query su 100.000 immagini. Entrambi supererebbero Qwen3-VL-Embedding-8B di oltre nove punti, e 9B sarebbe circa due sotto Gemini Embedding 2. Gli esterni non possono riprodurlo: sono dichiarazioni aziendali.
Query piccole non cancellano punteggio e memoria
Il denso salva un vettore per documento o frammento; late interaction ne conserva molti. MaxSim richiede più di un prodotto interno per candidato. Servire efficientemente richiede indici, potatura o fasi adeguate; documenti lunghi pesano anche a 128 dimensioni.
Occorre misurare separatamente codifica query, generazione candidati, MaxSim e successivi riordino o generazione. Un piccolo encoder può ancora attivare confronti costosi su milioni di vettori. Corpora variabili richiedono GPU continuative, ricodifica e cancellazioni.
Il denso resta utile a scala enorme, il lessicale protegge nomi e identificatori esatti, i cross-encoder riordinano liste limitate. Una base tecnica ibrida riserva indici visivi a pagine dipendenti dal layout, mantenendo testo per ricerca esatta, citazioni e prove. I contenuti non autorizzati vanno esclusi prima dell’agente; vettori locali-cloud compatibili non danno controllo di accesso.
L’uso sul dispositivo dipende da memoria, accelerazione, quantizzazione e batteria. Il piccolo pubblicato usa tensori F32; conversioni meno precise richiedono controlli del ranking. La scheda richiede Sentence Transformers 6.0+ e Transformers 5.4+, avvertendo che PyLate posiziona diversamente i marcatori di query e documento.
I moduli nativi Sentence Transformers evitano Python personalizzato ma non costruiscono un servizio. Nella scheda citata nessun provider di inferenza offriva il piccolo. L’API graduale promessa per embedding late interaction, densi e contestuali non è endpoint operativo né base per dedurre prezzi da vecchi servizi a vettore unico.
Pesi aperti rendono l’ipotesi verificabile, non risolta
MIT consente ampio uso e modifica, ma restano dipendenze, dati di addestramento e documenti sensibili da esaminare. Pesi e istruzioni non pubblicano l’intero corpus o insegnante 18B. L’esclusione dichiarata dei dataset legati ai benchmark richiede il rapporto promesso per controllare contaminazione, impostazioni e incertezza.
Le prove indipendenti devono riprodurre simmetria e asimmetria su materiali legali, finanziari, tecnici e scansioni, con duplicati, revisioni, permessi, impaginazioni simili, manoscritti e negativi difficili. Budget complessivi uguali evitano che OCR migliore, ricerche aggiuntive o riordino sembrino guadagni dell’embedding.
Decidono riproduzione indipendente, dati completi di hardware, latenza, compressione e memoria e supporto reale al percorso misto. Vanno misurati insieme ingestione, indice, richiamo, qualità e fallimenti. L’ipotesi è chiara: documenti offline e query online non richiedono identico calcolo. La superiorità sulla ricerca semplice dopo tutti i costi operativi rimane empirica.
Fonti e approfondimenti
Scheda modello 0,6B · Spiegazione tecnica · Approfondimento: ricerca nella conoscenza tecnica · Disegno BrowseComp+ · Studio MADQA · Annuncio