
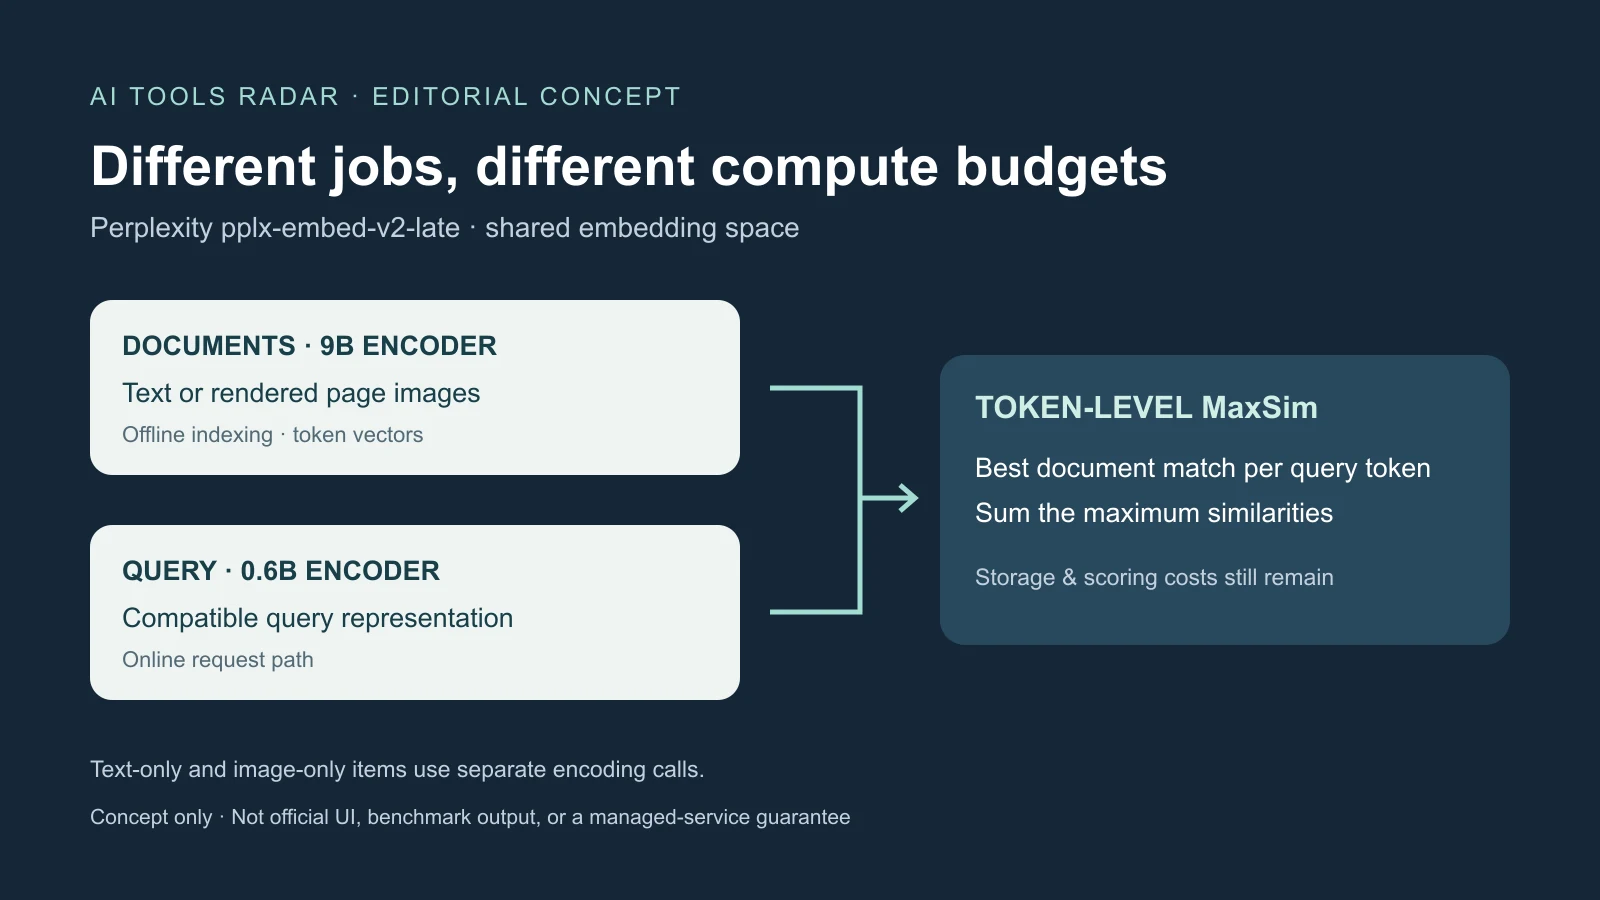
PerplexityのMITライセンスによるpplx-embed-v2-late二モデルは、マルチモーダル検索の分業を提案する。9Bで豊かな文書索引を作り、互換性のある0.6Bで実時間クエリーを処理できる。非対称構成を可能にするのは単なる小型化ではなく共有空間だ。
両者は文章、画像、描画済み文書ページを符号化する。文書処理はオフラインでまとめ、多数の検索へ費用を分散できる。クエリー処理は遅延に敏感な要求ごとに繰り返す。予算を分けるという実用仮説であり、総費用が安いという約束ではない。
トークンベクトルは単一表現が圧縮する詳細を保つ
密検索は通常、クエリーと文書・チャンクを一つずつのベクトルで表し、近傍探索を効率化する。分割は長さを緩和しても表とラベル、条文と限定を分離し得る。クロスエンコーダーは対を詳しく共同処理するが、候補ごとにモデル実行が必要で、短い一覧の再順位付けが一般的だ。
後期相互作用は文書を先に符号化しつつトークン表現を残す。各トークンは128次元で、MaxSimが各クエリートークンに最も近い文書トークンを選び最大類似度を合計する。法令、期限、例外を一つに混ぜず、同じページの別々の証拠へ対応させられる。
Qwen3.5基盤に双方向注意を使い、内部18B ColBERT教師から蒸留した。小型は全体を微調整し、9Bは最後のTransformer8層を全調整、残りと視覚エンコーダーはLoRAで調整したという。
小型の総数は約5.94億、活性化は3.4億で、文章約2.4億、画像約3.4億と報告される。Qwen3.5-0.8B文章塔を24層から12層へ削り、埋め込み表が別に2.54億を占める。「0.6B」は全入力が同じ計算を使う意味ではない。
共有空間により0.6Bクエリーで9B文書を検索でき、クエリー側交換だけで索引を作り直す必要はない。小型の端末符号化とクラウド9B索引も提案するが、自動的なプライバシーや管理サービスの保証ではない。
OCR不要の検索にも取り込み処理は必要
アプリはPDFページを画像へ描画してから視覚エンコーダーへ渡す。未準備のPDFファイルをそのまま処理するのではない。表の位置、図の関係、レイアウトを保ち、スキャンや特殊文字の認識誤りを避けられる場合がある。
ただし引用、強調表示、語彙検索、コンプライアンス、下流モデルの文脈に使う正確な文章は自動抽出されない。視覚で候補ページを見つけ、ネイティブ文章やOCRで証拠を取り出す併用が可能だ。描画、正規化、失敗処理、メタデータ、改訂、削除は依然アプリの仕事となる。
学習は594データセット、46言語、1.86億のクエリー・文書対とする。元の比率は文章対文章88.3%、文章対画像8.3%、文章対視覚文書3.4%、最終サンプリング重みは56.5%、30.9%、12.6%だった。写真検索と密な報告書内の証拠検索は違うため配分は重要だ。
取り込み制約として文章のみと画像のみは別の符号化呼び出しが必要で、一項目内の文章・画像混在は非対応だ。マルチモーダルという呼称でこの違いは消えない。
非対称の改善には特定の比較条件がある
72の分野別検索課題で、0.6Bクエリー・9B文書は両側0.6Bより平均1.6ポイント改善したとする。クエリーは同じままだ。ViDoRe v3画像のnDCG@10は63.5%対62.3%で1.2ポイント差だった。
両側9Bの分野平均81.3%がなお最高だった。非対称で文章品質差の約半分を回収できるという主張は、大型索引の検証を支持するもので、小型単独がすべての9B結果に並ぶ意味ではない。
公開ViDoRe v3画像では9B65.2%、0.6B62.3%、対応するMarkdownは64.7%、61.2%。小型は画像でNemotron ColEmbed V2 8Bから1.2ポイント以内とし、Qwen3-VL-Embedding、EVIE、TopK Embedとも比べる。
128次元はEVIE-4.5Bの2048、より大型のEVIEやNemotronの4096より少ないが、これは各トークンの次元だ。総索引は保持トークン数、精度、圧縮、メタデータ、索引構造、候補生成にも左右され、代表的な全コーパスの総保存計算は未公開だ。
回答ベンチマークは埋め込み以外も測る
BrowseComp+で9Bの回答正解率64.0%、次のColBERTより4.9、密モデルより8.7ポイント高いとする。難問830件、人工確認した証拠を持つ約10万ウェブ文書の固定集合は再現性を高めるが、変化する生ウェブと違う。
この結果は高推論GPT-OSS-120Bを組み合わせ、別モデルが参照回答との一致を判断した。エージェントと検索器の結果で単独埋め込み指標ではない。小型も系列外の全モデルに勝ったとするが、すべての点数が検索可能な文字で示されず、全技術報告は年内後半予定だった。
MADQAでGemini 3.5 Flashと組むと9B92.4%、0.6B90.1%。元論文は800文書に基づく人間作成2250問だが、この評価は1万8000ページ超の500問部分集合で、一般知識でなく文書証拠が必要になる。
9Bは同じエージェントの標準Mixedbread検索より3.5ポイント上。Mixedbread Agentic Searchは93.4%で同社の信頼区間内というが、外側の一呼び出しに複数検索を計画する副エージェントを含む。全サービスと検索部品は同条件比較ではない。
MADQA著者は、人間近い正解率でも正解する問題が異なり、弱い戦略を反復検索で補う場合を指摘する。良い検索も計画・統合を保証せず、回答率、証拠ページ再現率、検索品質、遅延、ツール回数を分けるべきだ。
私有PPLX-Q2Iは実運用画像ログから1万クエリーと10万画像を使う。両モデルがQwen3-VL-Embedding-8Bより9ポイント超高く、9BはGemini Embedding 2より約2ポイント低いという。外部再現できず企業帰属を保つ必要がある。
クエリー節約でも採点と保存は残る
密検索の文書・チャンク一ベクトルに対し、後期相互作用は多数のトークンを保持し、MaxSimも候補ごとの一内積より重い。適切な索引、枝刈り、段階検索が必要で、128次元でも長文の負担は増す。
クエリー符号化、候補生成、MaxSim、下流の再順位付け・生成を分けて測るべきだ。小型が作る要求でも何百万ベクトルとの照合は高価になり得る。頻繁な改訂は継続GPU能力、再符号化、削除の運用も要する。
巨大集合には密検索、正確な名前・識別子には語彙検索、限定候補にはクロスエンコーダーが残る。技術知識基盤はレイアウト依存ページへ視覚索引を限定し、文字で厳密検索や引用を補える。権限のない結果はエージェントへ渡す前に除外する必要があり、ローカルとクラウドの互換空間はアクセス制御ではない。
端末適性はメモリー、加速、量子化、電池次第だ。小型公開版はF32テンソルで、低精度変換には順位品質の確認が必要。モデルカードはSentence Transformers 6.0以上とTransformers 5.4以上を要求し、PyLateのクエリー・文書マーカー位置の違いも警告する。
ネイティブSentence Transformersは独自Pythonを不要にするだけで索引やサービスを完成させない。当時のカードで小型を提供する推論業者はなく、後期・密・文脈埋め込みのAPIへの段階追加は計画だった。稼働端点でも旧単一ベクトル価格を推定する根拠でもない。
公開重みは仮説を検証可能にするが確定しない
MITは広い使用改変を認めるが、依存関係、学習データ、機密文書の確認は必要だ。重みと実装手順の公開は全学習集合や内部18B教師の公開ではない。評価関連データを除いたとの主張も、汚染対策、設定、不確実性を調べる全報告が重要になる。
独立試験は法律、金融、技術、スキャンで対称・非対称を再現し、重複、改訂、権限、似た配置、手書き、難しい負例を含むべきだ。同じ全体予算でOCR、検索回数、再順位付けの差を埋め込みの改善と取り違えないことが必要だ。
決め手は独立再現、ハード・遅延・圧縮・保存の全報告、混合サイズ経路の実際の製品支援だ。取り込み量、索引量、証拠再現率、回答品質、失敗を共に測る。オフライン文書とオンライン検索は同じ計算予算でなくてよいという仮説は明確で、全運用費後も単純検索に勝つかは実証の問いである。
出典と関連情報
0.6Bモデルカード · Perplexity技術解説 · 関連:技術知識検索 · BrowseComp+設計 · MADQA論文 · 公開告知