
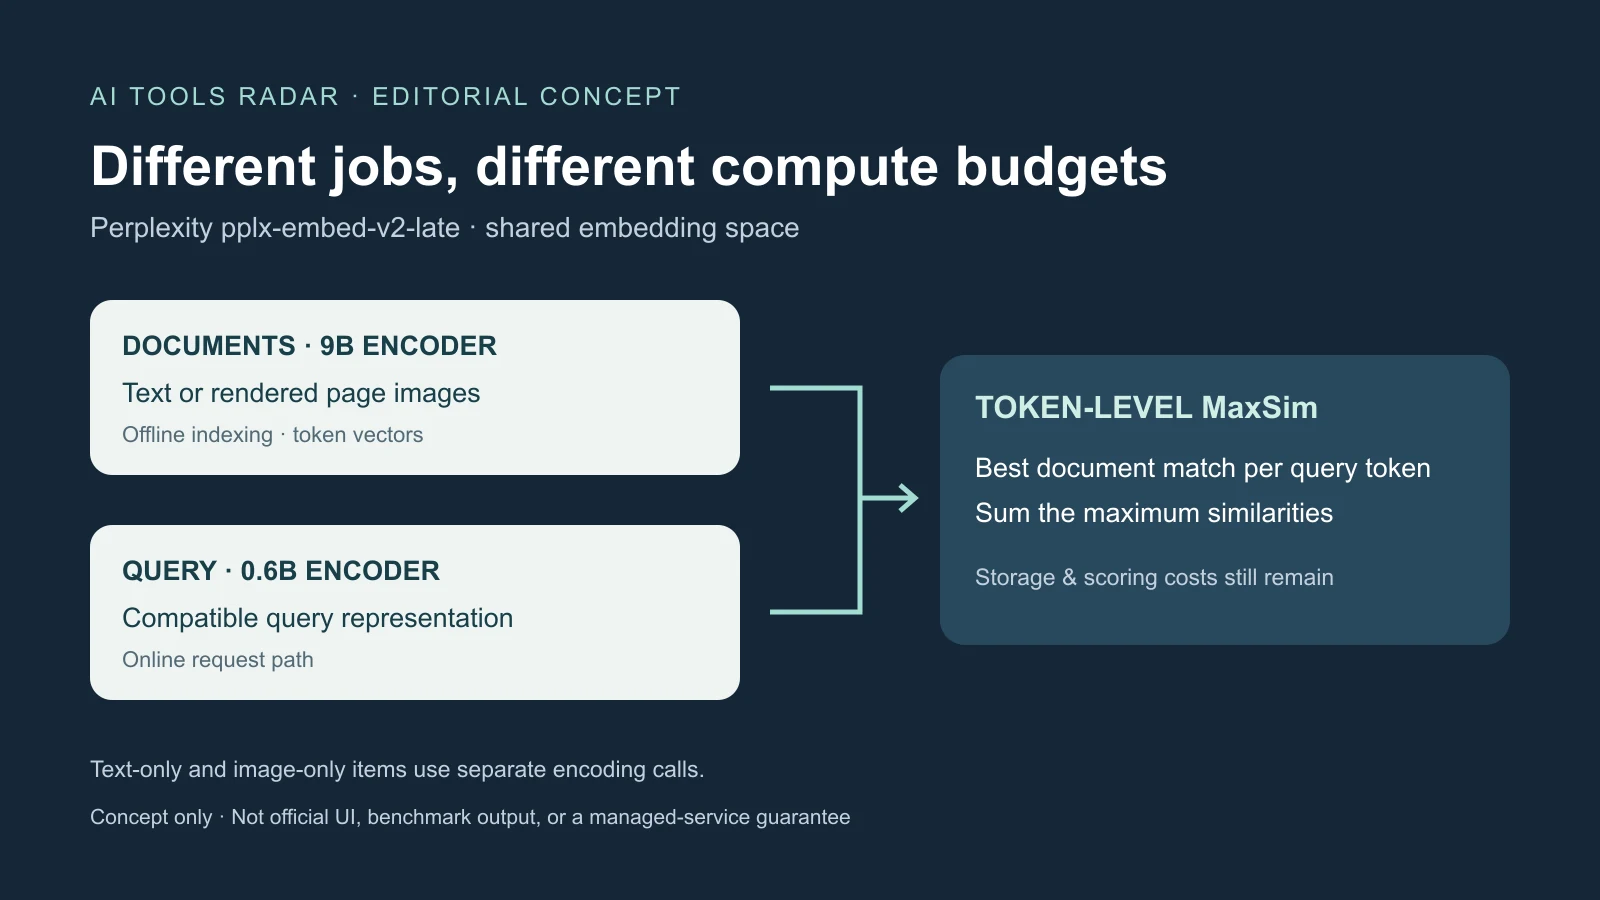
Les deux checkpoints pplx-embed-v2-late de Perplexity, sous MIT, proposent une autre répartition du travail de recherche multimodale. Un encodeur 9B peut construire un index documentaire plus riche, tandis qu’un 0,6B compatible traite les requêtes en direct. L’espace partagé, pas seulement moins de paramètres, permet cette asymétrie.
Tous deux encodent textes, images et pages rendues. Les documents se traitent hors ligne par lots, amortis sur de nombreuses recherches ; les requêtes reviennent dans un parcours sensible à la latence. Répartir différemment le calcul est l’hypothèse pratique, pas une promesse de faible coût global.
Les vecteurs de tokens conservent ce qu’un seul vecteur compresse
La recherche dense attribue généralement un vecteur à la requête et au document ou segment, permettant une recherche efficace de voisins. Découper aide avec la longueur mais peut séparer tableau et légende ou clause et réserve. Un cross-encoder compare la paire conjointement, mais répète le modèle pour chaque candidat et sert surtout à reclasser une liste courte.
Late interaction préencode les documents en gardant les tokens. Chacun produit 128 dimensions ; MaxSim choisit pour chaque token de requête la meilleure similarité documentaire et additionne ces maxima. Loi, délai et exception peuvent correspondre à différentes preuves d’une même page au lieu d’être fusionnés.
La famille Qwen3.5 utilise attention bidirectionnelle et distillation d’un enseignant ColBERT 18B interne. Le petit modèle a été entièrement ajusté ; pour 9B, les huit dernières couches Transformer ont été ajustées entièrement, les autres et l’encodeur visuel par LoRA.
Le petit compte environ 594 millions de paramètres totaux, avec 340 millions actifs annoncés : environ 240 millions pour le texte et 340 pour l’image. Sa tour Qwen3.5-0.8B passe de 24 à 12 couches ; la table d’embedding représente 254 millions supplémentaires. « 0,6B » ne signifie donc pas le même calcul actif pour chaque entrée.
L’espace commun permet aux requêtes 0,6B de chercher des documents 9B sans reconstruire l’index uniquement pour changer l’encodeur de requêtes. Perplexity propose aussi petit encodage local et index cloud 9B. Ce sont des options, pas des garanties automatiques de confidentialité ou de service géré.
Sans OCR ne signifie pas sans ingestion
L’application rend les pages PDF en images avant l’encodeur visuel, au lieu de transmettre un fichier non préparé. Les représentations peuvent préserver positions des tableaux, relations des diagrammes et mise en page, et éviter certaines erreurs de scans ou polices.
Elles n’extraient pas automatiquement des passages pour citations, surlignage, recherche lexicale, conformité ou contexte au modèle de langage. Texte natif ou OCR peut rester en parallèle : trouver la page prometteuse visuellement, puis récupérer la preuve exacte. Rendu, normalisation, erreurs, métadonnées, révisions et suppression restent applicatifs.
Perplexity rapporte 186 millions de paires issues de 594 datasets et 46 langues. Les proportions initiales étaient 88,3 % texte–texte, 8,3 % texte–image et 3,4 % texte–document visuel ; les poids finaux d’échantillonnage 56,5 %, 30,9 % et 12,6 %. Rechercher une photo et une preuve dans un rapport dense sont différents : le mélange compte.
Les éléments texte seul et image seule nécessitent des appels séparés ; un élément combinant texte et image n’est pas pris en charge. « Multimodal » n’efface pas cette contrainte d’ingestion.
Les gains asymétriques correspondent à des comparaisons précises
Sur 72 tâches de domaine, l’entreprise annonce en moyenne 1,6 point de pourcentage de gain pour requêtes 0,6B/documents 9B contre 0,6B des deux côtés, sans changer la requête. ViDoRe v3 images atteint 63,5 % nDCG@10 contre 62,3 %, soit 1,2 point.
Le 9B symétrique reste meilleur, à 81,3 % de moyenne. L’asymétrie récupérerait environ la moitié de l’écart textuel sans encodeur de requêtes plus grand. Cela justifie tester un grand indexeur, pas assimiler le petit modèle seul à tous les résultats 9B.
Les scores publics ViDoRe v3 images sont 65,2 % pour 9B et 62,3 % pour 0,6B ; Markdown donne 64,7 % et 61,2 %. L’entreprise situe le petit à 1,2 point de Nemotron ColEmbed V2 8B et compare aussi Qwen3-VL-Embedding, EVIE et TopK Embed.
128 dimensions par token s’opposent à 2 048 pour EVIE-4.5B et 4 096 pour les grands EVIE et Nemotron. Le vecteur individuel diminue, pas nécessairement tout l’index. Nombre de tokens, précision, compression, métadonnées, structure et candidats déterminent aussi le stockage ; un calcul complet sur corpus représentatifs manque.
Les benchmarks de réponse mesurent plus que les embeddings
Sur BrowseComp+, Perplexity annonce 64,0 % de réponses correctes pour 9B, 4,9 points devant le prochain ColBERT et 8,7 devant le prochain dense. Ses 830 requêtes difficiles et environ 100 000 documents web avec preuves validées par des humains donnent un corpus fixe reproductible, différent du Web changeant.
Le résultat associe récupération et GPT-OSS-120B à effort élevé, un autre modèle jugeant les réponses contre références. C’est un résultat agent-retriever, pas une métrique d’embedding isolée. Le petit dépasserait tous les modèles hors famille, mais tous les scores n’étaient pas disponibles en texte consultable ; le rapport complet était promis plus tard dans l’année.
MADQA avec Gemini 3.5 Flash atteint 92,4 % pour 9B et 90,1 % pour 0,6B. L’article d’origine décrit 2 250 questions humaines sur 800 documents ; cette évaluation prend 500 questions sur plus de 18 000 pages, exigeant des preuves du corpus et non des connaissances générales.
9B dépasse de 3,5 points le retriever Mixedbread standard avec le même agent. Mixedbread Agentic Search atteint 93,4 %, dans l’intervalle de confiance selon Perplexity, mais contient un sous-agent planifiant plusieurs recherches par appel externe. Un service complet n’est pas un composant équivalent.
Les auteurs MADQA notent que des systèmes proches de l’exactitude humaine réussissent des questions différentes et compensent une stratégie faible par des recherches répétées. Mieux récupérer ne garantit pas planification ou synthèse. Exactitude, rappel des pages de preuve, qualité, latence et appels d’outils doivent être séparés.
Le PPLX-Q2I privé utilise des journaux de production : 10 000 requêtes contre 100 000 images. L’entreprise dit que les deux dépassent Qwen3-VL-Embedding-8B de plus de neuf points, 9B restant environ deux derrière Gemini Embedding 2. Les tiers ne peuvent pas encore reproduire ce test ; l’attribution à l’entreprise reste nécessaire.
Les petites requêtes ne suppriment pas notation et stockage
Le dense conserve un vecteur par document ou segment ; late interaction beaucoup de tokens, avec MaxSim plus coûteux qu’un produit scalaire par candidat. Servir efficacement demande index adapté, élagage ou étapes ; les documents longs pèsent même à 128 dimensions.
Il faut mesurer séparément encodage, candidats, MaxSim et reclassement ou génération aval. Un petit encodeur peut toujours entraîner des comparaisons coûteuses parmi des millions de vecteurs. Les corpus changeants exigent GPU continus, réencodage et suppression.
Le dense garde son intérêt à très grande échelle, le lexical protège noms et identifiants exacts, les cross-encoders reclassent des candidats bornés. Une base technique hybride réserve le visuel aux pages dépendantes du layout, gardant le texte pour recherche exacte, citations et preuves. Filtrer les contenus interdits doit précéder l’agent ; des vecteurs locaux-cloud compatibles ne donnent aucun contrôle d’accès.
L’usage sur appareil dépend de mémoire, accélération, quantification et batterie. Le petit checkpoint utilise F32 ; réduire la précision exige de vérifier les classements. La fiche demande Sentence Transformers 6.0+ et Transformers 5.4+, avertissant que PyLate place différemment marqueurs de requête et document.
Les modules natifs Sentence Transformers évitent du Python personnalisé mais ne construisent pas l’index ou le service. Aucun fournisseur d’inférence n’hébergeait le petit dans la fiche citée. L’arrivée progressive prévue des embeddings late interaction, denses et contextuels dans l’API n’est pas un endpoint actif ni une base de prix tirée d’anciens services monovecteurs.
Les poids ouverts rendent l’hypothèse testable, pas acquise
MIT autorise largement usage et modification, sans dispenser de vérifier dépendances, données d’entraînement et documents sensibles. Poids et instructions ne publient ni corpus complet ni enseignant 18B. L’exclusion déclarée des datasets liés aux benchmarks nécessite le rapport promis pour examiner contamination, réglages et incertitude.
Les essais indépendants doivent reproduire symétrie et asymétrie sur droit, finance, technique et scans, avec doublons, révisions, permissions, mises en page proches, manuscrits et négatifs difficiles. Des budgets globaux égaux évitent d’attribuer aux embeddings un meilleur OCR, davantage de recherches ou de reclassement.
Les preuves décisives sont reproduction indépendante, mesures complètes de matériel/latence/compression/stockage et produit prenant réellement en charge les tailles mixtes. Ingestion, taille d’index, rappel, réponses et échecs vont ensemble. L’hypothèse est claire : documents hors ligne et requêtes en ligne n’exigent pas le même budget. Battre une recherche simple après tous les coûts opérationnels reste une question empirique.
Sources et lectures complémentaires
Fiche du modèle 0,6B · Explication technique · Complément : connaissances techniques consultables · Conception BrowseComp+ · Article MADQA · Annonce