
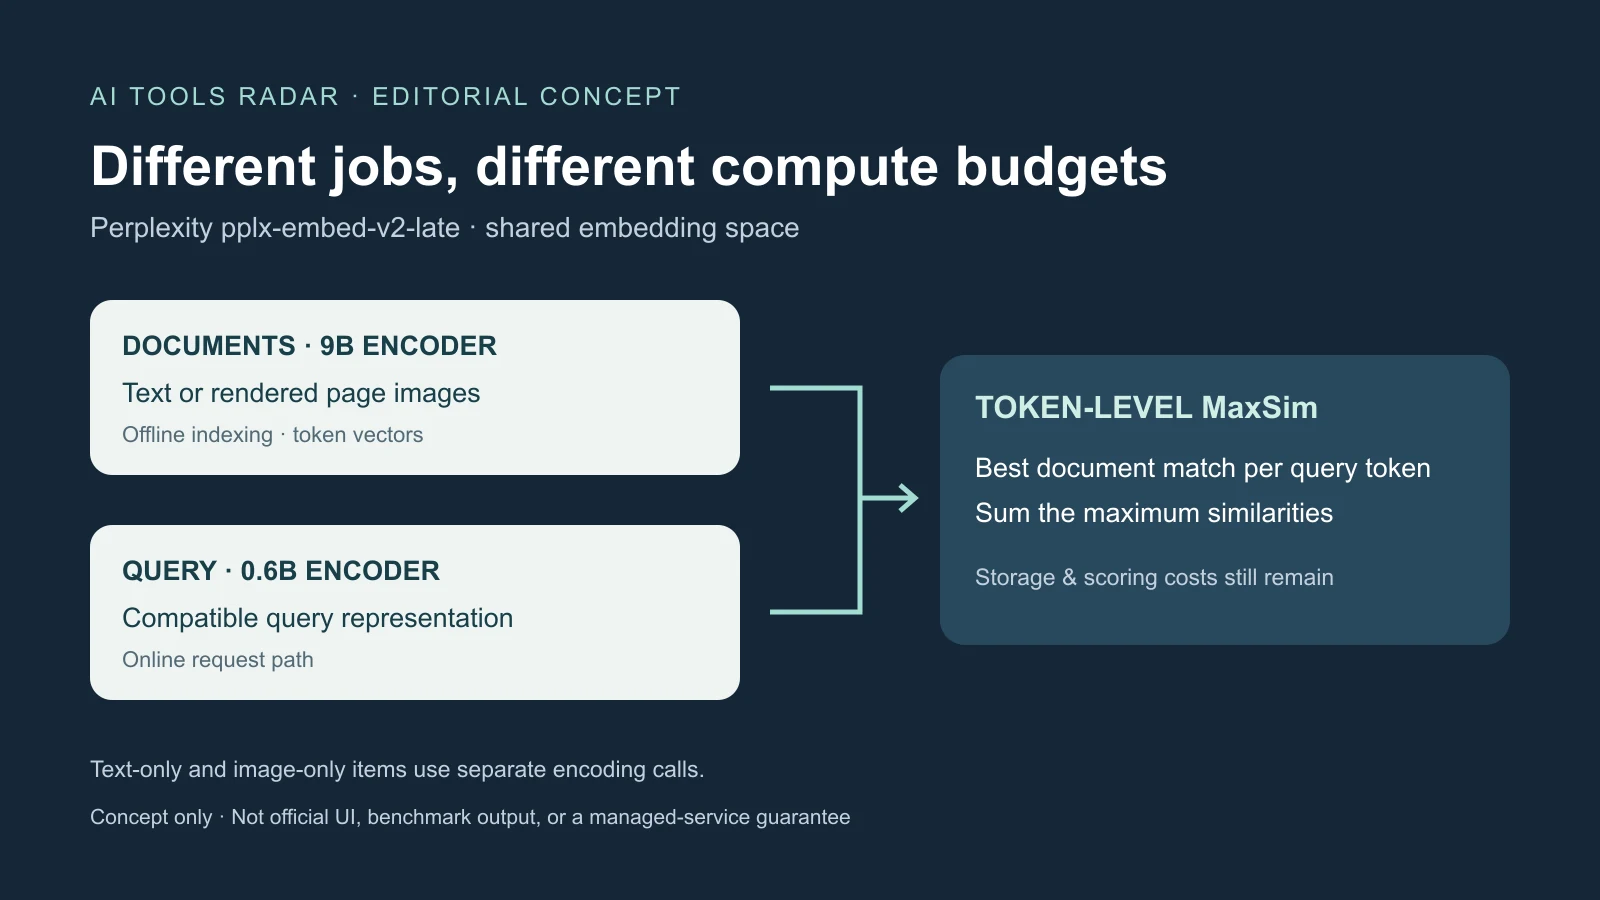
Perplexity의 MIT 라이선스 pplx-embed-v2-late 체크포인트 두 개는 멀티모달 검색의 다른 분업을 제안한다. 9B 인코더가 풍부한 문서 인덱스를 만들고 호환되는 0.6B가 실시간 질의를 처리할 수 있다. 비대칭 구성을 가능하게 하는 것은 단순한 소형화가 아니라 공통 공간이다.
둘 다 텍스트·이미지·렌더링 문서 페이지를 인코딩한다. 문서는 오프라인 일괄 처리해 여러 검색에 비용을 나누지만 질의는 지연에 민감한 요청마다 반복된다. 두 작업의 예산을 나누자는 실용 가설이지 전체 검색이 저렴하다는 약속은 아니다.
토큰 벡터는 단일 벡터가 압축하는 세부를 보존한다
밀집 검색은 보통 질의와 문서 또는 청크에 벡터 하나씩을 부여해 근접 이웃 검색을 효율화한다. 청크는 길이를 줄이지만 표와 레이블, 조항과 단서를 나눌 수 있다. 교차 인코더는 쌍을 함께 자세히 비교하되 후보마다 모델을 다시 실행하므로 대개 짧은 목록의 재순위에 쓴다.
Late interaction은 문서를 미리 인코딩하면서 토큰 표현을 유지한다. 토큰마다 128차원이며 MaxSim은 각 질의 토큰에 가장 유사한 문서 토큰을 찾아 최댓값을 합한다. 법 조항·기한·예외가 한 표현에 섞이지 않고 같은 페이지의 별도 근거와 맞을 수 있다.
Qwen3.5 기반 계열은 양방향 어텐션과 내부 18B ColBERT 교사 증류를 쓴다. 회사는 작은 모델을 전체 미세조정했고 9B는 마지막 Transformer 여덟 층을 전체 조정한 뒤 나머지와 시각 인코더에 LoRA를 적용했다.
작은 체크포인트는 총 약 5억9400만, 활성 3억4000만 파라미터로 보고된다. 텍스트는 약 2억4000만, 이미지는 3억4000만을 활성화한다. Qwen3.5-0.8B 텍스트 타워를 24층에서 12층으로 줄였고 임베딩 표는 추가 2억5400만이다. 0.6B가 모든 입력의 동일한 활성 계산을 뜻하지 않는다.
공통 공간 덕분에 0.6B 질의가 9B 문서를 검색하며 질의 인코더만 바꾸기 위해 인덱스를 재구축할 필요가 없다. 작은 로컬 인코더와 클라우드 9B 색인 조합도 제안됐다. 배포 선택지이지 자동 프라이버시나 관리형 서비스 보증은 아니다.
OCR 없는 검색에도 수집 파이프라인은 필요하다
앱은 PDF를 준비 없이 넣는 대신 페이지를 이미지로 렌더링한 후 시각 인코더에 전달한다. 표 위치·도표 관계·레이아웃을 보존하고 일부 스캔·폰트 인식 오류를 피할 수 있다.
그러나 인용·강조·키워드 검색·준법 검토·후속 언어모델 문맥에 필요한 정확한 글을 자동 추출하지 않는다. 시각으로 유망 페이지를 찾고 원문 텍스트나 OCR로 정확한 근거를 얻는 병행이 가능하다. 렌더링·정규화·실패 처리·메타데이터·수정·삭제는 앱의 일이다.
학습은 데이터셋 594개, 언어 46개, 질의·문서 쌍 1억8600만으로 보고됐다. 원래 비중은 텍스트 대 텍스트 88.3%, 이미지 8.3%, 시각 문서 3.4%였고 최종 샘플링 가중치는 56.5%·30.9%·12.6%였다. 사진 검색과 빽빽한 보고서의 근거 찾기는 달라 배합이 중요하다.
텍스트 전용과 이미지 전용 항목은 별도 인코딩 호출이 필요하며 한 항목에 텍스트와 이미지를 섞는 입력은 지원하지 않는다. 멀티모달이라는 이름이 이 수집 제약을 없애지 않는다.
비대칭 개선에는 특정 비교 조건이 있다
72개 도메인 검색 과제에서 0.6B 질의·9B 문서는 양쪽 0.6B보다 평균 1.6%포인트 높았다고 한다. 질의 인코더는 그대로다. ViDoRe v3 이미지 nDCG@10은 63.5% 대 62.3%로 1.2포인트 차이다.
양쪽 9B의 도메인 평균 81.3%가 여전히 최고였다. 회사는 더 큰 질의 인코딩 없이 텍스트 품질 격차 절반가량을 회복했다고 한다. 큰 인덱서 시험을 뒷받침하지만 작은 인코더 단독이 모든 9B 결과와 같다는 뜻은 아니다.
공개 ViDoRe v3 이미지는 9B 65.2%, 0.6B 62.3%, Markdown은 각각 64.7%·61.2%다. 작은 모델은 이미지에서 Nemotron ColEmbed V2 8B와 1.2포인트 이내라고 하며 Qwen3-VL-Embedding·EVIE·TopK Embed도 비교한다.
토큰당 128차원은 EVIE-4.5B 2048, 큰 EVIE·Nemotron 4096과 대비된다. 개별 벡터가 작아질 뿐 전체 인덱스가 반드시 작아지지는 않는다. 유지 토큰 수·정밀도·압축·메타데이터·구조·후보 생성도 저장을 정하며 대표 전체 코퍼스 계산은 없다.
답변 벤치마크는 임베딩 이상을 측정한다
BrowseComp+에서 9B 답변 정확도 64.0%, 다음 ColBERT보다 4.9포인트, 다음 밀집 모델보다 8.7포인트 높다고 한다. 어려운 질의 830개와 사람이 근거를 확인한 웹 문서 약 10만 개의 고정 집합은 재현을 돕지만 변하는 실시간 웹과 다르다.
이 점수는 높은 추론 노력의 GPT-OSS-120B와 결합하고 다른 모델이 참조 답과 일치하는지 판단했다. 에이전트·검색기 시스템 결과이지 독립 임베딩 점수가 아니다. 0.6B도 계열 밖 모든 모델보다 높다고 하지만 모든 점수가 검색 가능한 텍스트는 아니었고 전체 기술 보고서는 연내 나중에 예고됐다.
MADQA에서 Gemini 3.5 Flash와 결합한 답변 정확도는 9B 92.4%, 0.6B 90.1%다. 원 논문은 문서 800개에 사람이 쓴 2250문항이지만 이 평가는 1만8000페이지 이상에 걸친 500문항 부분집합으로 일반 지식이 아닌 자료 근거가 필요하다.
9B는 같은 에이전트의 표준 Mixedbread 검색보다 3.5포인트 높다. Mixedbread Agentic Search는 93.4%로 회사가 제시한 신뢰구간 안이라고 하지만 외부 호출마다 여러 검색을 계획하는 하위 에이전트를 포함한다. 전체 서비스와 검색 부품의 동등 비교는 아니다.
MADQA 저자들은 사람에 가까운 정확도의 시스템도 다른 문제를 맞히며 약한 전략을 반복 검색으로 보완할 수 있다고 지적한다. 더 나은 검색이 계획·종합을 보장하지 않는다. 답변 정확도·근거 페이지 재현율·검색 품질·지연·도구 호출을 따로 측정해야 한다.
비공개 PPLX-Q2I는 운영 이미지 로그의 질의 1만 개와 이미지 10만 개다. 두 모델이 Qwen3-VL-Embedding-8B보다 9포인트 넘게 높고 9B는 Gemini Embedding 2보다 약 2포인트 낮다고 한다. 외부 재현이 불가능해 회사 주장으로 남겨야 한다.
작은 질의가 점수 계산과 저장을 없애지 않는다
밀집 검색은 문서나 청크당 벡터 하나를 저장하지만 late interaction은 많은 토큰을 유지하고 MaxSim도 후보당 내적 한 번보다 무겁다. 효율적 서비스에는 적절한 색인·가지치기·단계 검색이 필요하고 긴 문서는 128차원에서도 부담을 키운다.
질의 인코딩·후보 생성·MaxSim·후속 재순위나 생성을 따로 재야 한다. 작은 인코더도 수백만 벡터와 비싼 비교를 일으킬 수 있다. 자주 바뀌는 코퍼스는 상시 GPU 색인 능력·재인코딩·삭제 운영을 필요로 한다.
밀집 검색은 거대 규모, 어휘 검색은 정확한 이름·식별자, 교차 인코더는 제한 후보 재순위에 유효하다. 기술 지식베이스는 레이아웃 민감 페이지만 시각 색인하고 텍스트로 정확한 검색·인용·근거를 보완할 수 있다. 권한 없는 결과는 에이전트 전달 전에 걸러야 하며 로컬·클라우드 벡터 호환은 접근 통제가 아니다.
단말 적합성은 메모리·가속·양자화·배터리에 달린다. 공개 작은 모델은 F32 텐서이며 낮은 정밀도 변환은 순위 품질 확인이 필요하다. 카드 요구사항은 Sentence Transformers 6.0+와 Transformers 5.4+이며 PyLate의 질의·문서 마커 위치가 다르다고 경고한다.
네이티브 Sentence Transformers는 사용자 정의 Python을 피할 뿐 색인이나 서비스를 완성하지 않는다. 인용된 카드 당시 작은 모델을 제공하는 추론 업체는 없었다. Late interaction·밀집·맥락 임베딩의 점진적 API 계획은 가동 엔드포인트가 아니며 기존 단일 벡터 가격으로 추정할 근거도 아니다.
열린 가중치는 가설을 시험 가능하게 할 뿐 확정하지 않는다
MIT는 넓은 이용·수정을 허용하지만 의존성·학습 데이터·민감 문서를 검토해야 한다. 가중치와 구현 안내가 전체 학습 코퍼스나 내부 18B 교사를 공개한 것은 아니다. 벤치마크 관련 데이터 제외 주장도 오염 통제·설정·불확실성 검토에는 약속된 보고서가 필요하다.
독립 시험은 법률·금융·기술·스캔에 대칭과 비대칭을 재현하고 중복·수정·권한·비슷한 배치·손글씨·구분하기 어려운 비관련 문서(하드 네거티브)를 포함해야 한다. 더 나은 OCR·추가 검색·재순위가 임베딩 이득으로 보이지 않도록 전체 예산을 같게 해야 한다.
결정적 증거는 독립 품질 재현, 하드웨어·지연·압축·저장 전체 보고, 혼합 크기 경로의 실제 제품 지원이다. 수집 처리량·인덱스 크기·근거 재현율·답변·실패를 함께 재야 한다. 오프라인 문서와 온라인 질의에 같은 계산 예산이 필요 없다는 가설은 명확하지만 모든 운영비 후 단순 검색보다 나은지는 실증 문제다.
출처와 관련 자료
0.6B 모델 카드 · 기술 설명 · 관련: 기술 지식 검색 · BrowseComp+ 설계 · MADQA 논문 · 출시 발표