
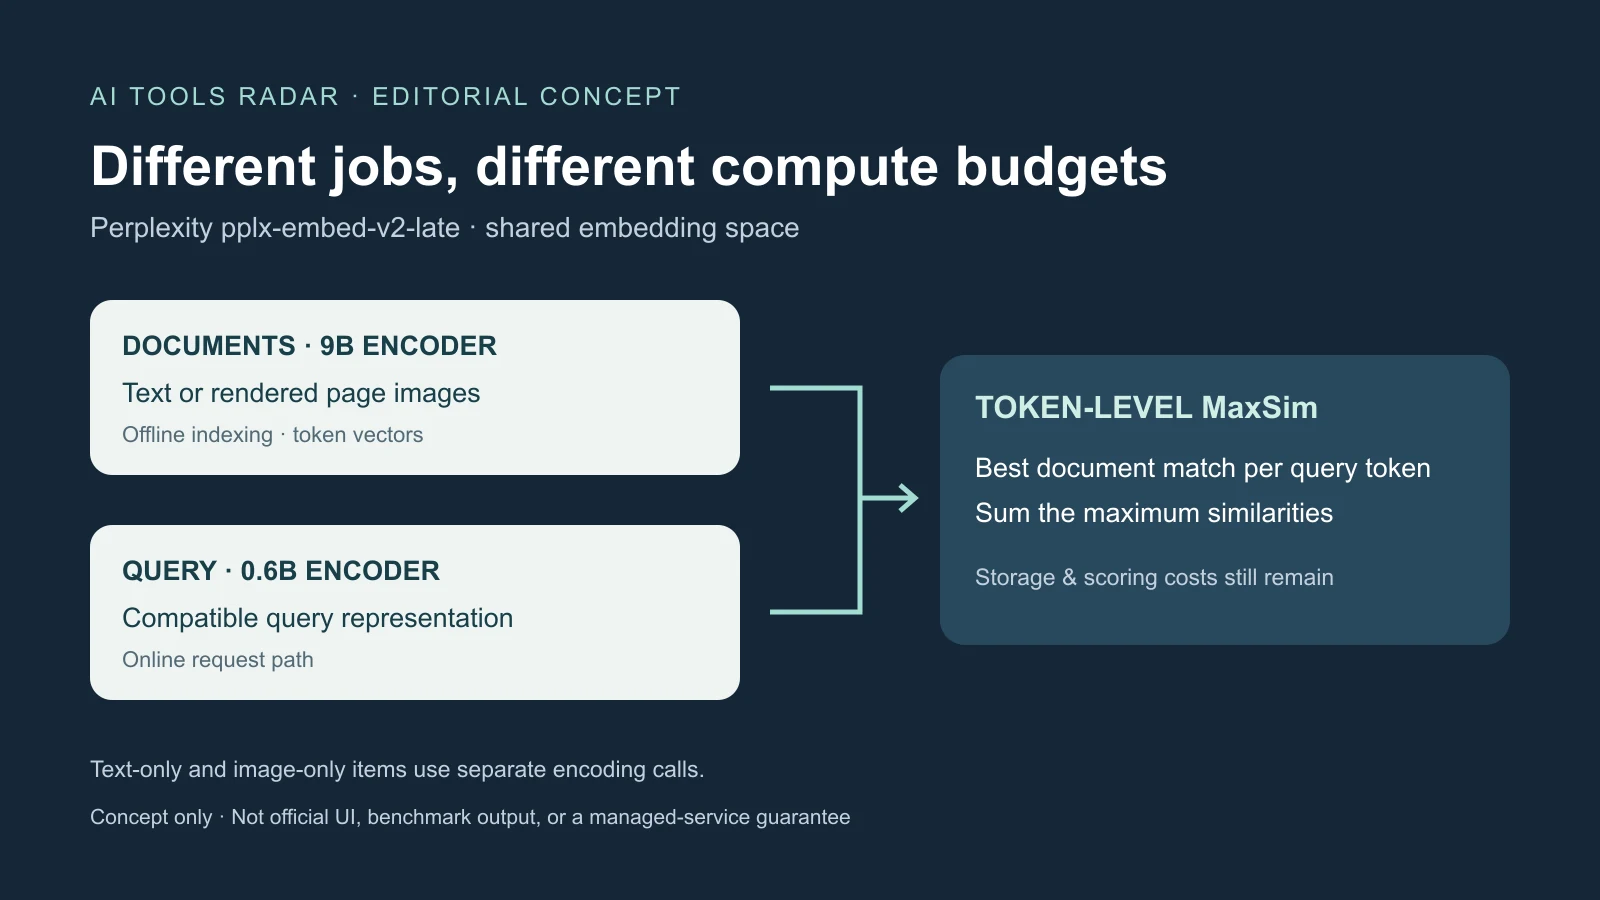
Perplexity发布的两款MIT许可pplx-embed-v2-late模型,为多模态检索提出不同分工:9B编码器建立更丰富的文档索引,兼容的0.6B编码器处理实时查询。让这种非对称配置成立的是共享空间,而不只是较少参数。
两者均可编码文本、图像和渲染后的文档页面。文档处理可以离线批量进行,成本由多次搜索分摊;查询编码则在延迟敏感的请求路径上反复发生。分别分配算力是待验证的实用假设,并非总搜索成本必然低廉的承诺。
词元向量保留单向量压缩的信息
稠密检索通常为查询和文档或切块各给一个向量,便于高效近邻搜索。切块缓解长度问题,却可能把表格与标签、条款与限定条件分开。交叉编码器联合细读查询和候选,但每一对都要重新运行,通常只适合短候选列表重排。
晚期交互预先编码文档,同时保留词元表示。每个词元输出128维向量,MaxSim为每个查询词元寻找最相似的文档词元,再把最大相似度相加。法条、期限与例外可以分别匹配同页不同证据,而非混入一个综合表示。
该系列基于Qwen3.5,使用双向注意力,并从内部18B ColBERT教师蒸馏。Perplexity对小模型全量微调;9B则全调最后八层Transformer,其余层和视觉编码器使用LoRA。
小模型总参数约5.94亿,公司报告活跃参数3.4亿,其中文本约2.4亿、图像约3.4亿。Qwen3.5-0.8B文本塔由24层裁成12层,词元嵌入表另占2.54亿参数。因此“0.6B”不代表每种输入激活同样的计算量。
共享空间让0.6B查询可搜索9B编码文档,更换查询编码器不必因此重建索引。公司也提出小模型本地编码、云端9B索引的组合。这是部署选项,不是自动隐私保障或托管服务保证。
无OCR检索仍需要入库流程
应用先把PDF页面渲染成图像,再由视觉编码器处理,并非直接把未经准备的PDF文件交给检索。视觉表示能保留表格位置、图示关系和版式,也可能避免扫描和特殊字体中的识别错误。
它却不会自动提供引文、高亮、关键词搜索、合规检查或下游模型所需的准确文字。原生文本或OCR可以与视觉搜索并用:先找可能含证据的页面,再提取精确内容。分页渲染、归一化、异常处理、元数据、修订和删除仍归应用负责。
Perplexity称训练包含594个数据集、46种语言、1.86亿查询—文档对。原始比例为文本对文本88.3%、文本对图像8.3%、文本对视觉文档3.4%;最终采样权重变为56.5%、30.9%、12.6%。检索照片和寻找密集报告页证据不是同一任务,训练平衡因此重要。
入库还有一项限制:纯文本和纯图像条目需要分别调用编码,单个条目不支持混合文字与图像。“多模态”并未取消这一区别。
非对称提升有明确比较对象
Perplexity报告,在72项领域检索任务上,0.6B查询配9B文档比两侧都用0.6B平均提高1.6个百分点,查询编码器未变。ViDoRe v3图像检索中,这一组合nDCG@10为63.5%,对照62.3%,相差1.2个百分点。
两侧都用9B的领域平均分仍最高,为81.3%。公司称非对称配置在不增大实时查询编码的情况下,找回约一半文本质量差距。这支持测试大索引器,不代表小模型单独达到每项9B结果。
公开ViDoRe v3图像分数为9B的65.2%和0.6B的62.3%,对应Markdown分数64.7%和61.2%。公司称小模型图像检索距Nemotron ColEmbed V2 8B仅1.2个百分点,并与Qwen3-VL-Embedding、EVIE、TopK Embed比较。
每词元128维,对比EVIE-4.5B的2048维,以及较大EVIE和Nemotron的4096维,降低的是单个词元维数,不一定是整个索引。保留词元数、精度、压缩、元数据、索引结构与候选生成共同决定存储;尚无代表性完整语料的总成本计算。
回答基准测量的不只是嵌入
Perplexity称9B在BrowseComp+回答准确率64.0%,分别领先下一款ColBERT与稠密模型4.9、8.7个百分点。该基准有830条难查询、约10万篇经人工确认支撑证据的网页文档。固定语料有利复现,却不同于持续变化的实时网络。
这一结果搭配高推理力度GPT-OSS-120B,并由另一模型对照参考答案判断,是智能体与检索器的系统结果,不是独立嵌入指标。公司称0.6B超过系列外所有模型,但完整分数并未全部以可搜索文字公开;完整报告计划当年稍后发布。
MADQA配Gemini 3.5 Flash时,9B与0.6B回答准确率分别92.4%、90.1%。原论文包含800份文档、2250个人工问题;Perplexity使用500题子集,覆盖超过1.8万页,要求从语料取证,而非依赖常识。
9B比相同智能体使用标准Mixedbread检索高3.5个百分点。Mixedbread Agentic Search为93.4%,公司称落在自身置信区间内,但该服务有子智能体,可在每次外层调用规划多次搜索。完整服务与单个检索组件不是等价对比。
MADQA作者指出,接近人类准确率的系统可能答对不同题目,还会通过重复搜索弥补策略不足。更好检索不保证规划和综合正确。答案准确率、证据页召回、检索质量、延迟和工具调用次数须分别测量。
内部PPLX-Q2I来自生产图像搜索日志,用1万查询检索10万图像。公司称两模型领先Qwen3-VL-Embedding-8B超过9个百分点,9B落后Gemini Embedding 2约2个百分点。外部尚不能复现私有测试,这些仍是公司陈述。
查询节省没有抹去评分与存储代价
稠密检索每文档或切块存一个向量;晚期交互保留多个词元向量,MaxSim也比每候选一个内积更费计算。高效服务需要适配索引、剪枝或分阶段检索;即便128维,长文档仍增加负担。
应分别测量查询编码、候选生成、MaxSim评分以及下游重排或生成。小查询编码器仍可能产生对数百万向量的昂贵匹配。语料频繁变化还需要持续GPU索引能力、重新编码与删除流程。
稠密检索适合超大规模,词法检索保护准确姓名、标识符,交叉编码器可重排有限候选。混合技术知识库可只为版式敏感页面保留视觉索引,文字仍负责精确查找、引用与提取证据。未授权内容必须在结果进入智能体前被过滤;本地与云端向量兼容不是权限系统。
边缘可行性取决于设备内存、加速支持、量化与电量。公开小模型使用F32张量,低精度转换须检查排名质量。模型卡要求Sentence Transformers 6.0及以上、Transformers 5.4及以上,并提醒PyLate的查询和文档标记位置不同。
原生Sentence Transformers模块避免自定义Python代码,却不代建索引或服务。所引模型卡当时没有推理提供商托管小模型。晚期交互、稠密、上下文嵌入逐步接入API的计划,不是已上线端点,也不能照旧单向量服务推算价格。
开放权重让假设可测,而不是已经定论
MIT支持广泛使用修改,采用者仍须检查依赖、训练数据及敏感文件处理。开放权重与实现说明不等于公开全部训练语料和内部18B教师。公司称排除了与评测相关的数据集,承诺报告仍对核查污染控制、参数和不确定性重要。
独立试验应在法律、财务、技术和扫描材料复现对称与非对称组合,包含重复、修订、权限、相似版式、手写和困难负例。相同端到端预算应避免更强OCR、更多搜索轮次或重排被误当成嵌入提升。
关键证据是独立质量复现、完整硬件/延迟/压缩/存储数据,以及真正支持大小模型混合路径的产品。应同时测量入库吞吐、索引体积、证据召回、回答质量和失败案例。它的假设很明确:离线文档和在线查询不必使用同一算力预算。计入全部运维成本后能否胜过更简单检索,仍是实证问题。
来源与延伸阅读
0.6B模型卡 · Perplexity技术说明 · 延伸:技术知识库检索 · BrowseComp+设计 · MADQA论文 · 发布公告