
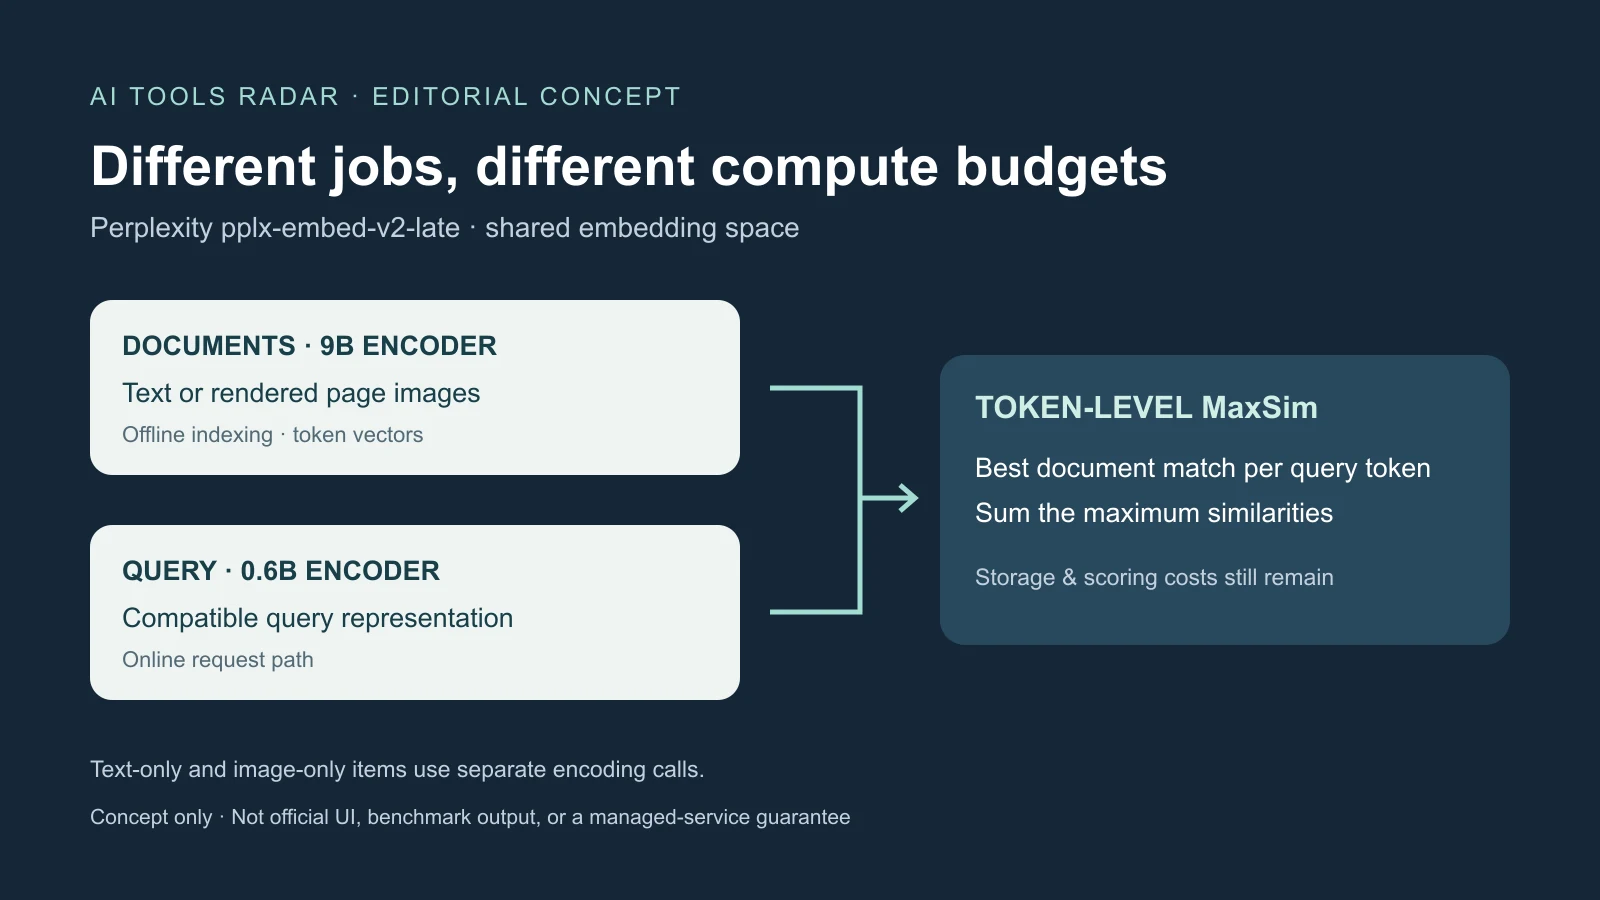
Dwa modele pplx-embed-v2-late Perplexity na licencji MIT proponują inny podział pracy w wyszukiwaniu multimodalnym. Enkoder 9B może tworzyć bogatszy indeks dokumentów, a zgodny 0,6B obsługiwać zapytania na żywo. Asymetrię umożliwia wspólna przestrzeń, nie sama mniejsza liczba parametrów.
Oba kodują tekst, obrazy i wyrenderowane strony. Dokumenty można przetwarzać partiami offline i rozłożyć koszt na liczne wyszukiwania; zapytania powtarzają się w ścieżce wrażliwej na opóźnienia. Różne budżety tych zadań są hipotezą praktyczną, nie obietnicą taniego całego systemu.
Wektory tokenów zachowują szczegóły tracone w jednym wektorze
Gęste wyszukiwanie zwykle daje po jednym wektorze zapytaniu i dokumentowi lub fragmentowi, pozwalając na szybkie szukanie sąsiadów. Dzielenie tekstu pomaga z długością, lecz może rozdzielić tabelę i podpis lub klauzulę i zastrzeżenie. Cross-encoder analizuje parę wspólnie, ale działa od nowa dla każdego kandydata, zwykle tylko przy przestawianiu krótkiej listy.
Late interaction koduje dokumenty wcześniej, zachowując reprezentacje tokenów. Każdy ma 128 wymiarów. MaxSim wybiera dla każdego tokenu zapytania największe podobieństwo do tokenu dokumentu i sumuje maksima. Przepis, termin i wyjątek mogą trafiać w różne dowody tej samej strony, zamiast mieszać się w jednym opisie.
Rodzina oparta na Qwen3.5 używa uwagi dwukierunkowej i destylacji z wewnętrznego nauczyciela ColBERT 18B. Mniejszy model dostrojono w całości; w 9B pełne strojenie objęło ostatnie osiem warstw Transformera, a resztę i enkoder obrazu dostosowano przez LoRA.
Mały model ma około 594 mln parametrów łącznie i deklarowane 340 mln aktywnych: około 240 mln dla tekstu i 340 mln dla obrazów. Wieżę tekstową Qwen3.5-0.8B skrócono z 24 do 12 warstw; tablica embeddingów wnosi kolejne 254 mln. „0,6B” nie oznacza jednakowego aktywnego obliczania dla wszystkich wejść.
Wspólna przestrzeń pozwala zapytaniom 0,6B przeszukiwać dokumenty 9B bez przebudowy indeksu tylko z powodu zmiany enkodera zapytań. Firma proponuje też mały enkoder lokalny i indeks 9B w chmurze. To opcje wdrożenia, nie automatyczna prywatność ani gwarancja usługi zarządzanej.
Wyszukiwanie bez OCR nadal potrzebuje przetwarzania wejścia
Aplikacja renderuje strony PDF jako obrazy przed enkoderem wizji, nie przekazuje nieprzygotowanego pliku bezpośrednio. Reprezentacja wizualna może zachować pozycje tabel, relacje diagramu i układ oraz uniknąć części błędów rozpoznawania skanów i czcionek.
Nie dostarcza jednak automatycznie tekstu do cytatów, podświetleń, wyszukiwania słów, zgodności i kontekstu modelu językowego. Tekst natywny lub OCR może pozostać obok: obraz znajduje stronę, tekst daje dokładny dowód. Renderowanie, normalizacja, błędy, metadane, wersje i usuwanie pozostają pracą aplikacji.
Perplexity podaje 186 mln par z 594 zbiorów i 46 języków. Pierwotne proporcje to 88,3% tekst–tekst, 8,3% tekst–obraz i 3,4% tekst–dokument wizualny; końcowe wagi próbkowania wynosiły 56,5%, 30,9% i 12,6%. Fotografia i dowód w gęstej stronie raportu to inne problemy, więc mieszanka ma znaczenie.
Elementy wyłącznie tekstowe i wyłącznie obrazowe wymagają osobnych wywołań kodowania; mieszany tekst z obrazem w jednym elemencie nie jest obsługiwany. Nazwa multimodalna nie usuwa tego ograniczenia.
Zyski asymetrii dotyczą określonych porównań
Na 72 zadaniach domenowych firma podaje średnio 1,6 punktu procentowego więcej dla zapytań 0,6B i dokumentów 9B niż dla 0,6B po obu stronach, przy niezmienionym zapytaniu. ViDoRe v3 dla obrazów daje 63,5% nDCG@10 wobec 62,3%, czyli 1,2 punktu różnicy.
Symetryczny 9B pozostał najlepszy ze średnią domenową 81,3%. Asymetria miała odzyskać około połowy luki jakości tekstowej bez większego enkodera online. To argument za testem dużego indeksatora, nie twierdzenie, że mały model sam dorównuje każdemu wynikowi 9B.
Publiczne ViDoRe v3 miało dla obrazów 65,2% dla 9B i 62,3% dla 0,6B, a Markdown odpowiednio 64,7% i 61,2%. Firma umieszcza mały model w odległości 1,2 punktu od Nemotron ColEmbed V2 8B i porównuje Qwen3-VL-Embedding, EVIE oraz TopK Embed.
128 wymiarów na token kontrastuje z 2048 w EVIE-4.5B i 4096 w większych EVIE i Nemotron. Mniejszy jest pojedynczy token, niekoniecznie cały indeks. Liczba zachowanych tokenów, precyzja, kompresja, metadane, struktura i generowanie kandydatów także decydują o pamięci; brak pełnych obliczeń dla reprezentatywnych korpusów.
Benchmarki odpowiedzi mierzą więcej niż embeddingi
Firma podaje dla 9B 64,0% trafności na BrowseComp+, przewagę 4,9 punktu nad kolejnym ColBERT i 8,7 nad modelem gęstym. Zbiór 830 trudnych zapytań i około 100 000 kuratorowanych stron z dowodami sprawdzonymi przez ludzi poprawia powtarzalność, ale nie jest zmiennym internetem na żywo.
Wynik łączy wyszukiwanie z GPT-OSS-120B przy wysokim wysiłku, a inny model ocenia odpowiedzi względem wzorców. To wynik agenta i retrievera, nie osobnego embeddingu. 0,6B miał przewyższyć wszystkie modele spoza rodziny, ale nie wszystkie wyniki były dostępnym do wyszukania tekstem; pełny raport zapowiedziano na później w roku.
MADQA z Gemini 3.5 Flash daje 92,4% dla 9B i 90,1% dla 0,6B. Oryginalny artykuł opisuje 2250 pytań ludzi do 800 dokumentów; ta ocena używa podzbioru 500 pytań i ponad 18 000 stron, wymagając dowodów korpusu zamiast wiedzy ogólnej.
9B przewyższył standardowy Mixedbread z tym samym agentem o 3,5 punktu. Mixedbread Agentic Search uzyskał 93,4%, według Perplexity w jego przedziale ufności, ale zawiera subagenta planującego kilka wyszukiwań w jednym wywołaniu zewnętrznym. Cała usługa i komponent nie są identycznym porównaniem.
Autorzy MADQA zauważają, że systemy bliskie ludziom mogą trafiać w inne pytania i nadrabiać słabą strategię powtarzaniem wyszukiwań. Lepszy retriever nie gwarantuje planowania lub syntezy. Trafność odpowiedzi, recall stron dowodowych, jakość wyszukiwania, opóźnienie i liczba narzędzi wymagają osobnych pomiarów.
Prywatny PPLX-Q2I pochodzi z logów produkcyjnych: 10 000 zapytań do 100 000 obrazów. Firma deklaruje ponad dziewięć punktów przewagi obu modeli nad Qwen3-VL-Embedding-8B, a 9B około dwóch poniżej Gemini Embedding 2. Test nie jest odtwarzalny z zewnątrz i pozostaje deklaracją firmy.
Mały enkoder nie usuwa punktacji i pamięci
Gęste wyszukiwanie zapisuje jeden wektor na dokument lub fragment; late interaction wiele tokenów. MaxSim wymaga więcej niż jednego iloczynu skalarnego na kandydata. Potrzebne są odpowiednie indeksy, przycinanie lub etapy; długie dokumenty kosztują nawet przy 128 wymiarach.
Należy mierzyć osobno kodowanie zapytań, generowanie kandydatów, MaxSim i późniejsze przestawianie lub generowanie. Mały enkoder nadal wywoła kosztowne porównania z milionami wektorów. Częste zmiany korpusu wymagają stałej mocy GPU, ponownego kodowania i usuwania.
Gęsta metoda przydaje się w ogromnej skali, leksykalna chroni dokładne nazwy i identyfikatory, a cross-encoder sortuje ograniczonych kandydatów. Hybrydowa wiedza techniczna może zachować obrazy dla stron zależnych od układu, tekst zaś do dokładnego szukania, cytowania i dowodów. Nieuprawnione treści trzeba odfiltrować przed agentem; zgodne lokalne i chmurowe wektory nie zapewniają kontroli dostępu.
Urządzenia brzegowe zależą od pamięci, akceleracji, kwantyzacji i baterii. Publiczny mały model ma tensory F32; mniejsza precyzja wymaga kontroli rankingu. Karta wymaga Sentence Transformers 6.0+ i Transformers 5.4+ oraz ostrzega o innej pozycji znaczników zapytania i dokumentu w PyLate.
Natywne moduły Sentence Transformers unikają niestandardowego Pythona, ale nie budują całej usługi. W cytowanej karcie żaden dostawca inferencji nie obsługiwał małego modelu. Plan stopniowego API dla late interaction, gęstych i kontekstowych embeddingów nie jest gotowym punktem końcowym ani podstawą cen ze starszych usług jednowektorowych.
Otwarte wagi pozwalają testować hipotezę, nie kończą sporu
MIT umożliwia szerokie użycie i modyfikację, lecz pozostają zależności, dane treningowe i dokumenty wrażliwe do sprawdzenia. Wagi i instrukcje nie ujawniają pełnego korpusu ani nauczyciela 18B. Deklaracja wykluczenia danych związanych z benchmarkami wymaga zapowiedzianego raportu do oceny kontaminacji, ustawień i niepewności.
Niezależne testy powinny odtworzyć symetrię i asymetrię na prawie, finansach, technice i skanach, z duplikatami, wersjami, prawami, podobnym układem, pismem ręcznym i trudnymi negatywami. Równe budżety całego systemu zapobiegną przedstawianiu lepszego OCR, dodatkowych wyszukiwań lub sortowania jako zysku embeddingu.
Rozstrzygające będą niezależna reprodukcja jakości, pełne dane sprzętu, opóźnień, kompresji i pamięci oraz rzeczywista usługa mieszanej ścieżki. Trzeba łączyć przepustowość wejścia, indeks, recall, odpowiedzi i błędy. Hipoteza jest jasna: dokumenty offline i zapytania online nie potrzebują tej samej mocy. Przewaga nad prostszym wyszukiwaniem po wszystkich kosztach pozostaje pytaniem empirycznym.
Źródła i dodatkowa lektura
Karta modelu 0,6B · Wyjaśnienie techniczne · Kontekst: przeszukiwalna wiedza techniczna · Projekt BrowseComp+ · Artykuł MADQA · Ogłoszenie premiery